Games101:幾何(Geometry)
Games101:幾何(Geometry)
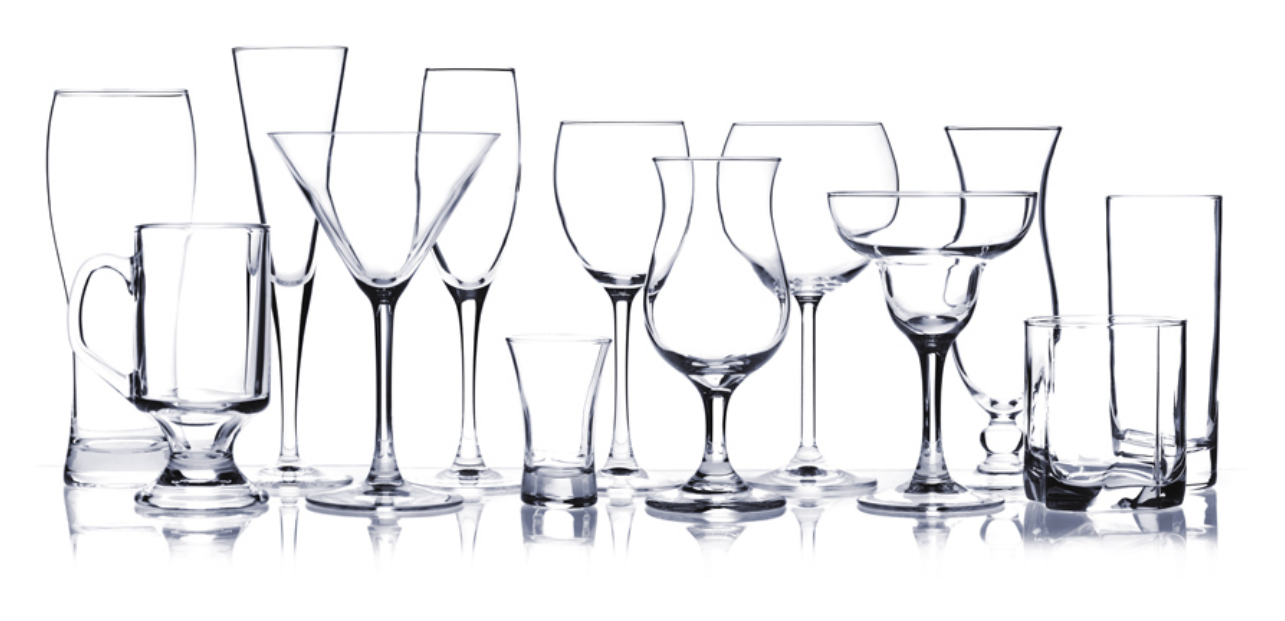
我們這章會從幾個具體例子,來看不同的幾何表示方法。 像是下圖的玻璃杯,它上面有各種不同的曲線,我們該如何描述這些曲線呢?
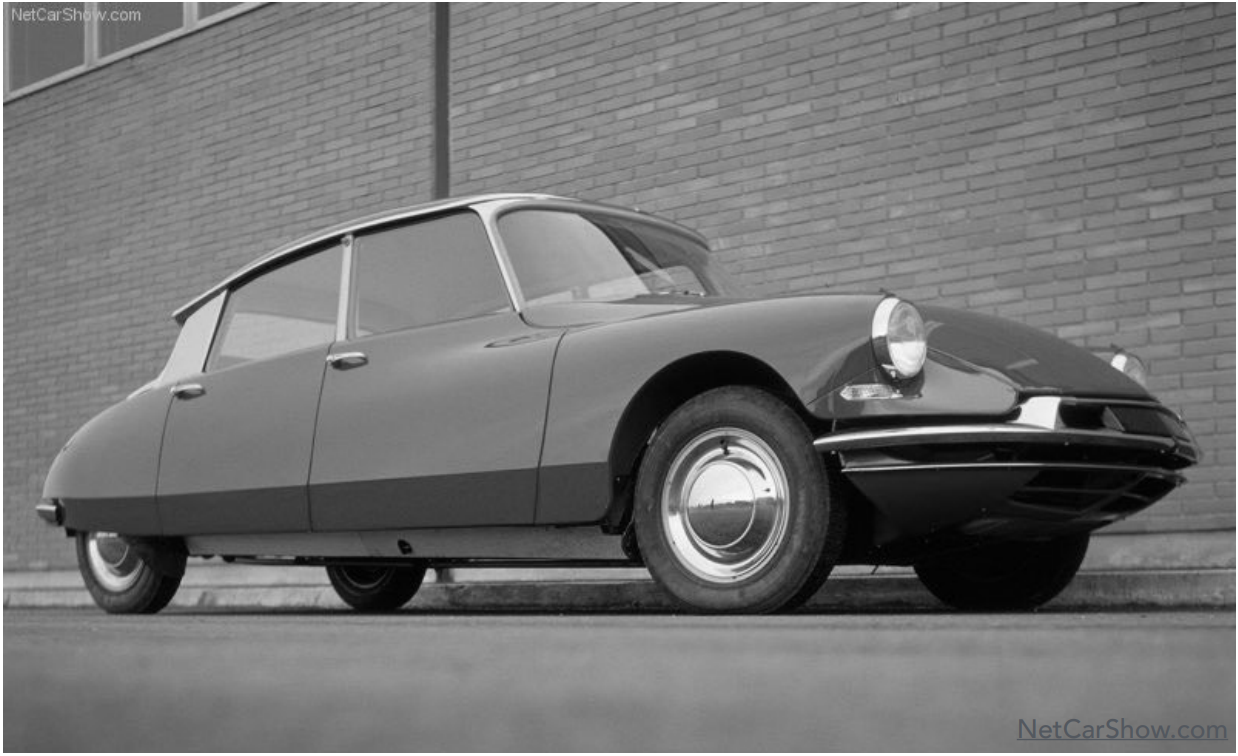
我們再來看下面這台車,在車頭的曲面上我們看不到任何三角形,它具有非常光滑的曲面,不管我們離多近,都看不到離散的三角形,這在圖學裡面又該如何被描述呢?
除了杯子與車身以外,我們還會遇到不同尺度的幾何問題。 像是布料的纖維(fiber)會先扭成股(ply),多股又會形成紗線(thread),紗線最後會交織成布料。 這種分層結構會影響布料的外形、縫隙與透光情形,我們使用的幾何模型也會跟觀察距離有關
又或者像是水花會在運動時分離或融合,物體表面的連接關係也會跟著改變; 城市場景會同時包含建築、室內空間、樹葉與草地; 毛髮則會在很小的範圍內包含大量細節。 因此在做的時候我們需要同時考慮幾何的表示方式、儲存成本,以及算繪時真正需要保留的細節
幾何的表示方法(Ways to Represent Geometry)
隱式幾何(Implicit geometry)
在圖學裡我們有兩種表示幾何的方法,第一種是隱式的幾何(Implicit geometry),另一種是顯式的幾何(Explicit geometry)。 隱式的幾何會以關係式來表示目標形體,例如一個三維空間裡面的單位球可以被寫成
只要我們有了一個三維空間中的座標,就能夠判斷它是不是在這個球面上
隱式幾何的壞處在於,今天給我們一個式子,我們很難看出它表示的是什麼形狀。 例如下圖是一個圓環,但單看式子我們其實很難看出來它是一個圓環:
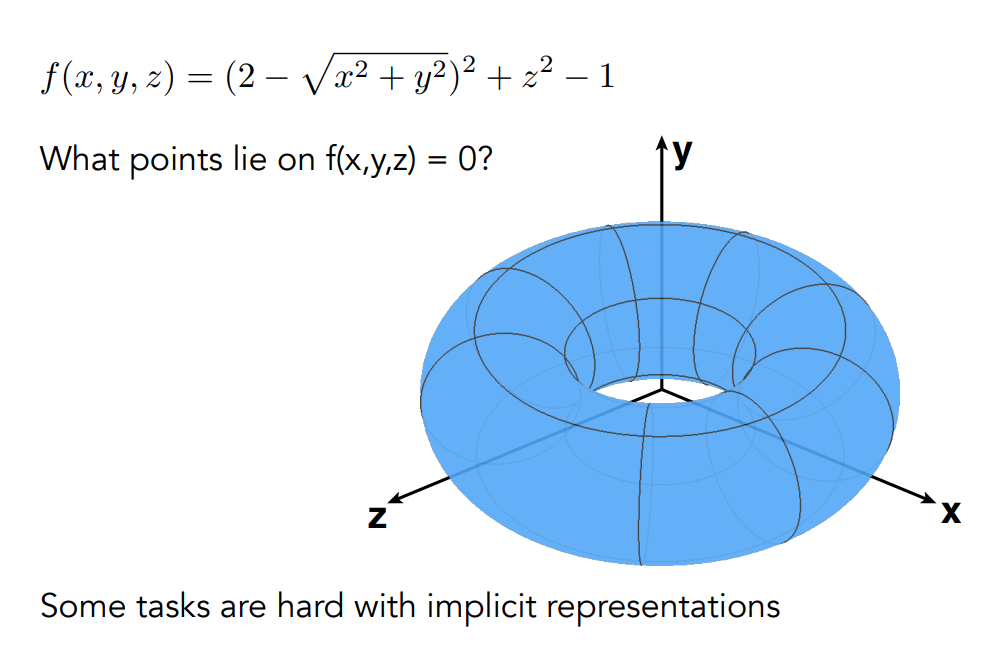
而隱式幾何的優點在於,我們可以很容易地判斷一個點在不在幾何的表面上,只需要把我們的座標帶入函數就可以算出來了,通常為 0 就代表在表面上,如果是個負數就代表在幾何內部,反之如果是個正數就代表在幾何外面。 當然,這還是要看你的式子怎麼定義的,但通常我們會設
顯式幾何(Explicit geometry)
顯式幾何是比較典型的表示方法,我們之前用的三角形面就是顯式的表示方法,真的給我們一些點,組成三角形,進而將模型表現出來。 但還有另一種顯式的方法,稱為參數映射,以下圖為例,你可以看到我們定義了要如何將給定的
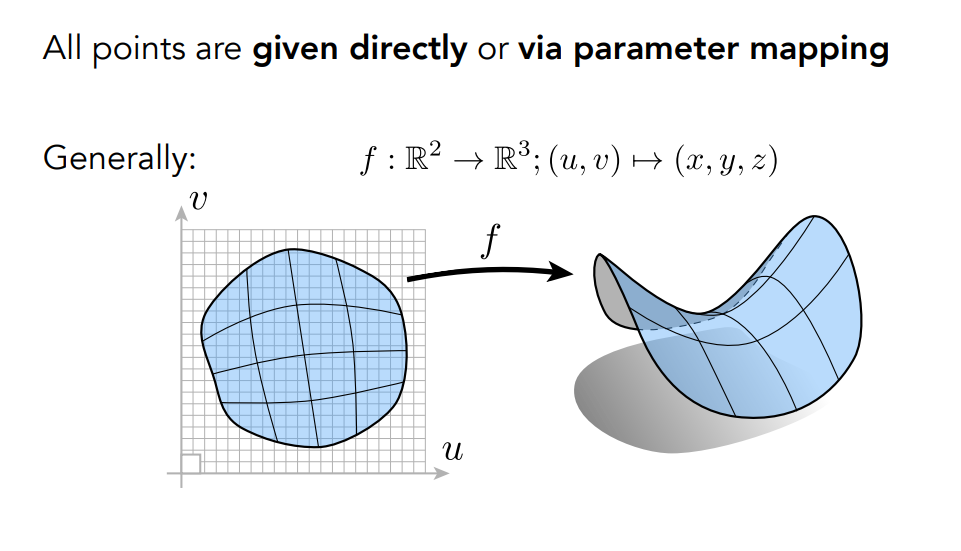
也就是說,我們可以定義一個函數,輸入是
我們再看一次圓環的例子:
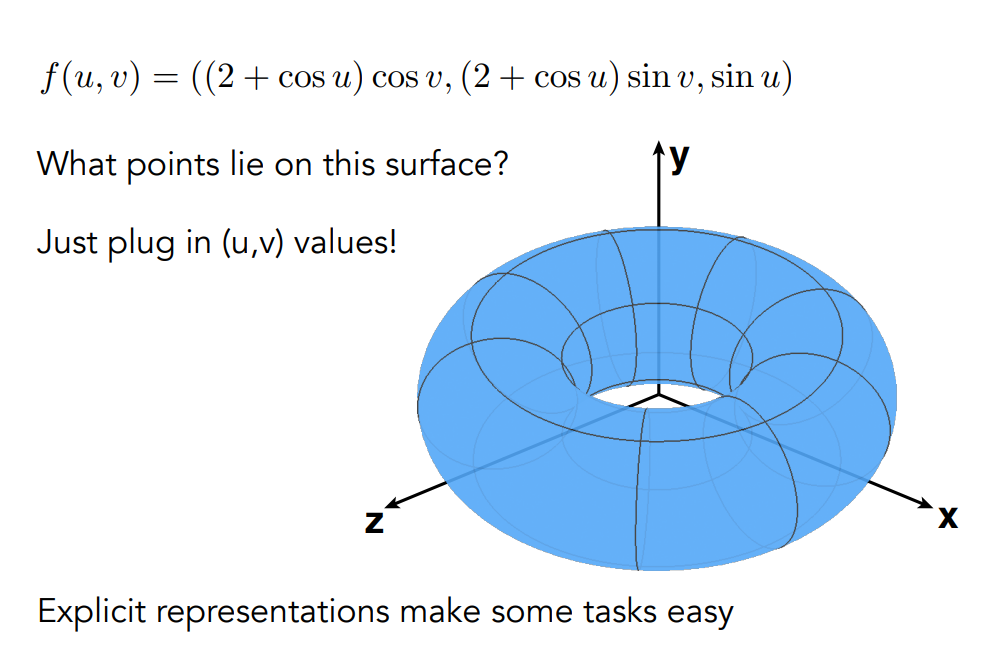
這邊我們把
這就是為什麼它叫顯式幾何,如果我們想知道這個幾何長怎樣,只要把
顯式幾何的缺點是,當給我們一個三維空間中的點,我們很難去判斷一個點在不在目標幾何的表面上,或說表面的內側或外側
電腦圖學中的隱式表示法(Implicit Representations in Computer Graphics)
我們再來看幾個隱式幾何的例子。 這些形狀都可以用函數表示,但我們未必能直接從公式想像出形狀:
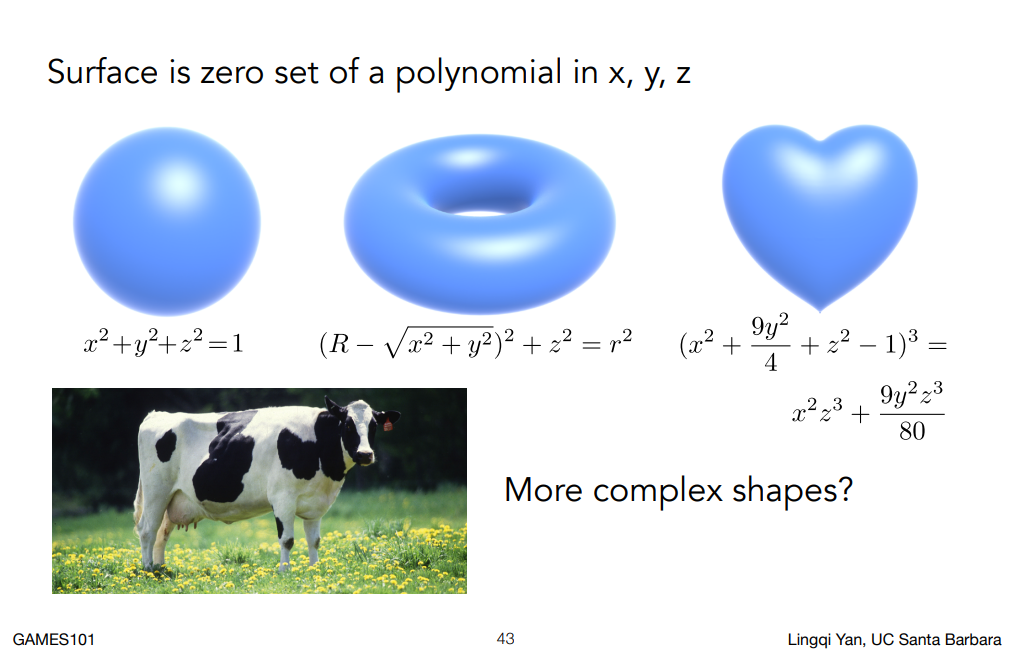
球面的公式我們可能可以看出來,而圓環的公式就已經有點勉強了,再到更右邊的心型就更難看了。 接著,如果我們想要直接找到一個公式能代表上圖中的乳牛,這件事就會變得非常困難
不過有一些工具可以幫助我們組合出幾何形狀,接下來我們就來介紹一下這些方法
建構式實體幾何(Constructive Solid Geometry)
我們首先要介紹的方法叫做建構式實體幾何(Constructive Solid Geometry),簡稱為 CSG。 CSG 會透過一系列基本的幾何運算,來組合出一個新的幾何,如下圖:
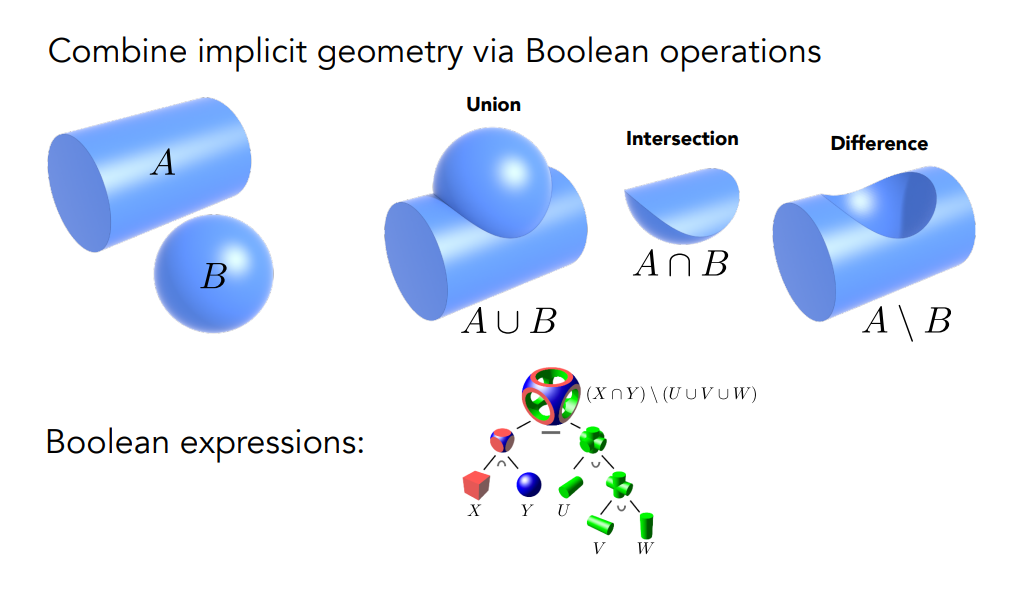
圖中的 A、B 為一個圓柱和一顆球,我們可以很容易地寫出它們的隱式關係式。 接著我們這邊透過布林運算將它們組合到了一起。 這邊的布林運算與集合論裡面的操作是一樣的,做 intersection 就是取它們交集的部分,取 union 就是兩者的聯集,而差集也可以定義,只要從 A 中間減去 B 所佔據的 A 的部分即可,反之同理
我們透過這些運算和一些簡單的基礎幾何,就可以像上圖下方那樣組出複雜的幾何,並用布林運算的組合式表示它了。 例如,我們先取立方體與球的交集,再扣掉三根互相垂直的圓柱所形成的聯集,就會得到鏤空骰子的形狀。 Maya、AutoCAD 等建模軟體都支援這類操作
距離函數(Distance Function)
我們接下來要看距離函數,它也是一種描述幾何的方法。 距離函數會記錄查詢點到物體表面的最近距離,而帶正負號的距離函數還會利用符號區分物體內部與外部。 看下面的例子:
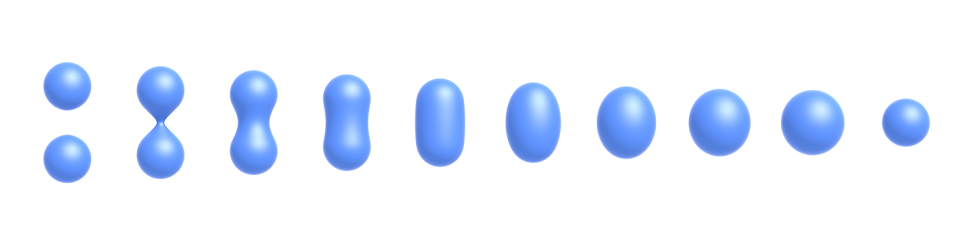
我們可以看到圖中的兩個球會逐漸靠近,最後融合成一個形狀,表面的連接關係也跟著改變了。 這個例子會透過距離函數的混合(blend),產生幾何之間的過渡形狀
再來看個比較具體的例子:
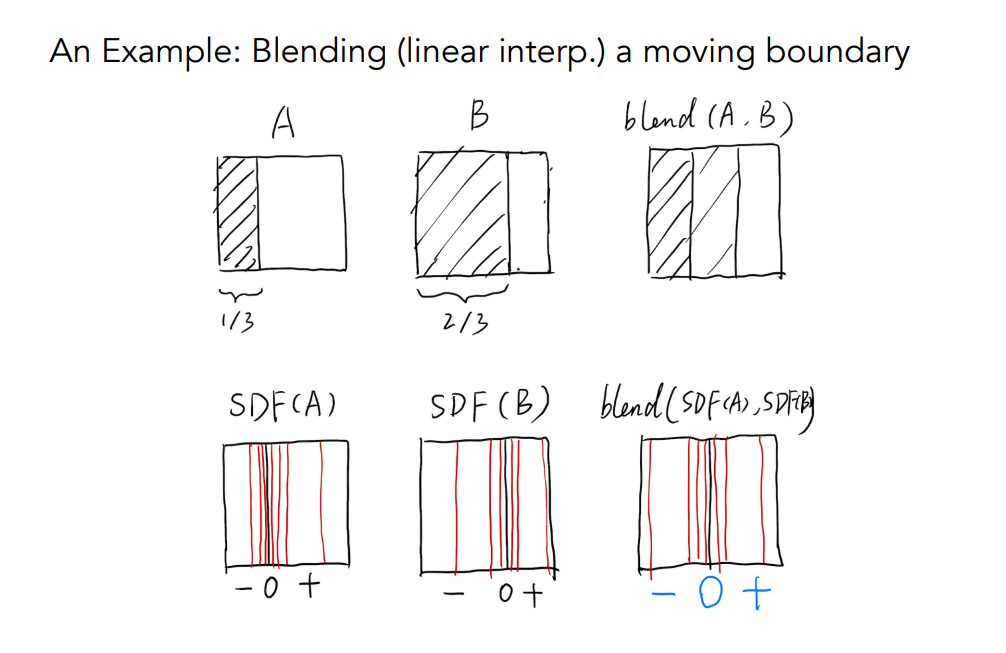
這邊用的距離函數被稱為帶正負號的距離函數(Signed Distance Function,SDF)。 我們的目的是要將 A 與 B 這兩個不同的方塊混合,它們各自擁有一部分的黑色區域與一部分的空白區域。 如果我們直接做線性的混合,混合結果就會變成一個黑⭢灰⭢白的方塊,因為重疊的部分肯定最黑,而中間部分只有 B 有塗色,所以是灰的,而最右邊都沒塗色,所以是白的
但如果我們希望混合結果仍然具有明確的黑白邊界,那就可以使用 SDF。 我們先分別求出 A 與 B 的距離函數,再混合兩個函數,就能取到右下角方塊中間的那條黑線。 那條黑線代表的就是距離函數等於 0 的狀態,接下來我們就可以根據其他位置距離函數的值來判斷黑/白(左/右)
我們可以把這個過程寫成公式。 假設物體佔據的區域為
我們若想得到 A 與 B 之間的過渡形狀,可以先混合兩個距離場,再取出混合結果的零值表面:
在前面的黑白方塊例子中,我們可以把左右邊界分別設成
我們知道原理後,再看下面的形狀變化就會比較容易理解了:
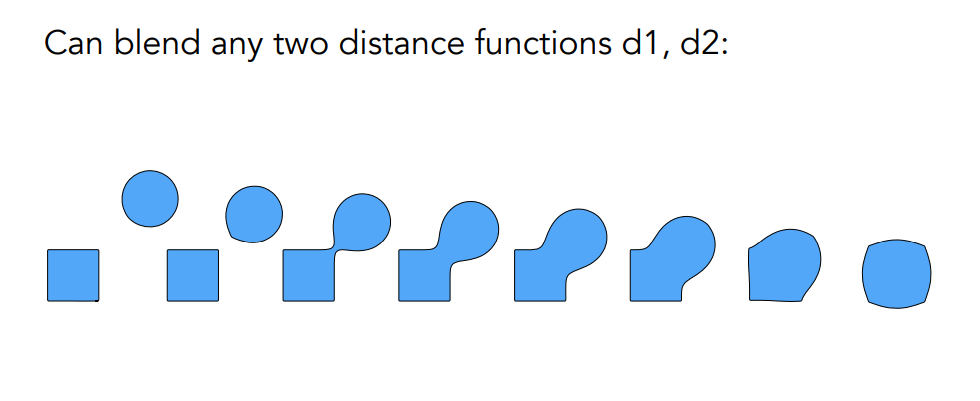
我們如果分別求出兩個物體的距離函數,再混合它們並取出零值表面,就會得到這種形狀變化。 混合後的函數不一定仍然是精確的 SDF,但它的零值表面仍然能定義幾何邊界
等位集合方法(Level-set method)
距離函數還可以配上一些其他的方法用,假設有個距離函數不好寫成參數式的形式,也就是不容易寫成 SDF 的格式,那也沒關係,只要能通過某種方法表述出來就可以了
在這邊我們介紹一種方法,叫做 level-set method。 它會把函數值儲存在格點上,再用相同函數值所構成的集合來描述表面:
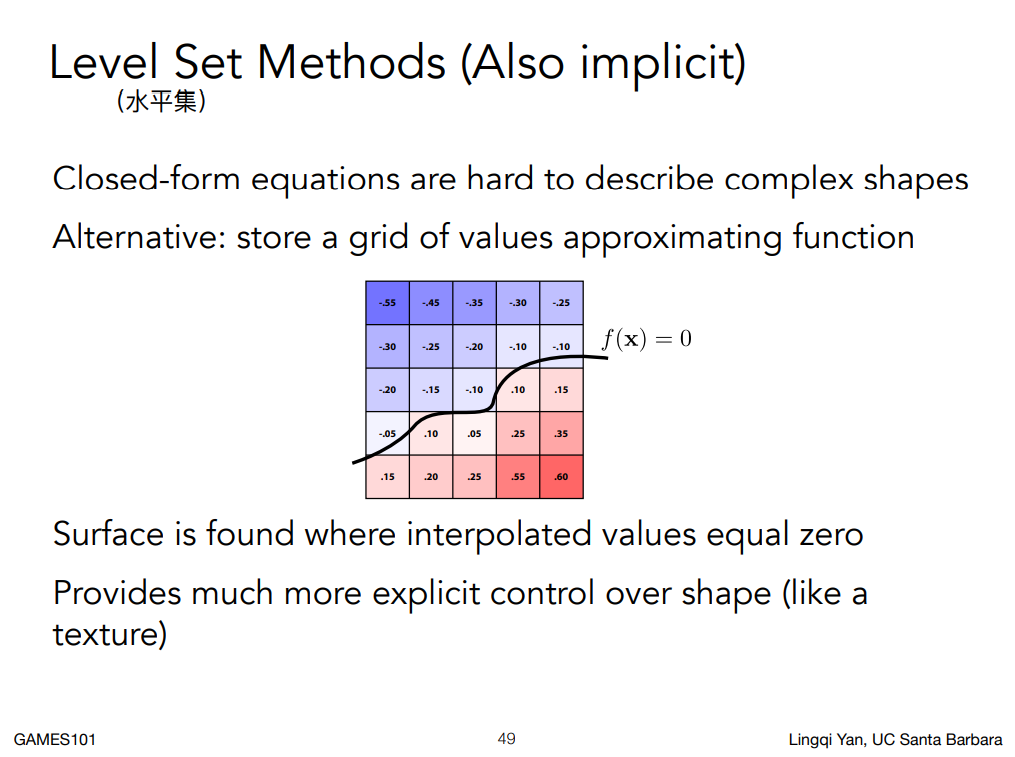
你可以看到函數在不同的地方有不同的值,接著我們只需要將值為 0 的地方連起來,就可以把整個物體的表面給表述出來了。 這個概念在地理上已經用了很久,就是所謂的等高線
我們也不一定得定義在二維的格子上,也可以在三維的格子上,結合紋理使用,就可以如下圖這樣描述出人體不同位置的密度訊息:
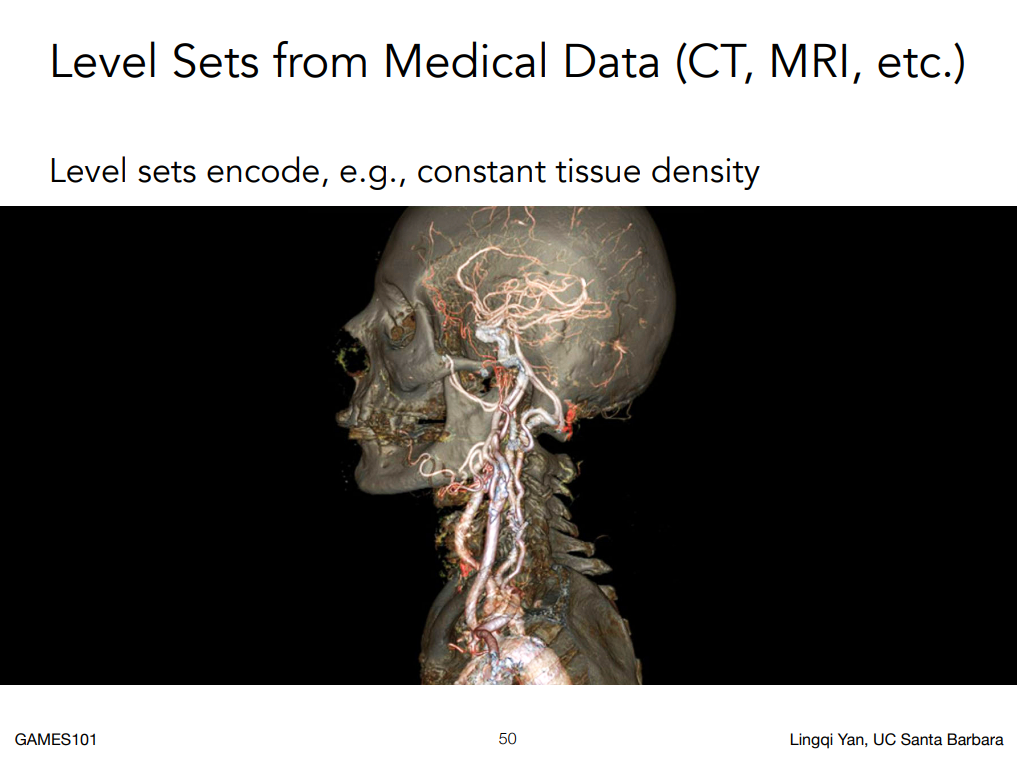
我們如果把格點上的純量值記成
距離場的表面通常對應
分形(Fractals)
我們最後來看分形(fractals),這是種具有遞迴與自相似結構的幾何。 自相似表示了局部形狀會和整體相似,而我們可以透過重複套用某些規則來產生這種結構。 自然物體也可能在有限尺度內呈現近似的自相似形狀
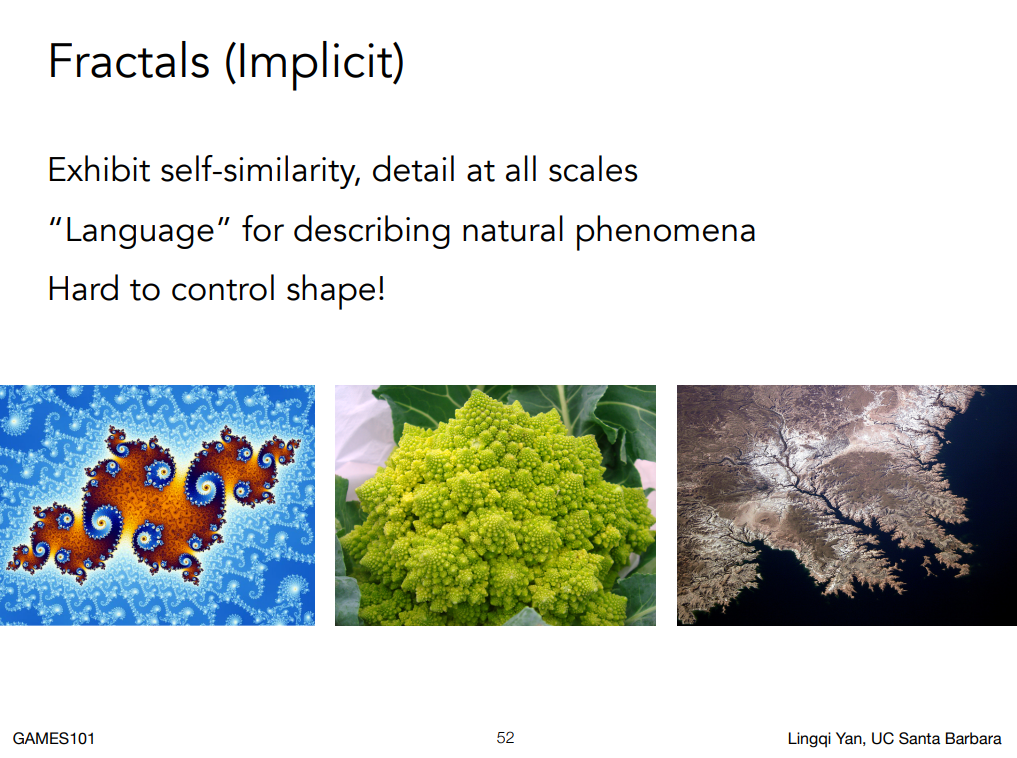
分形可能會在細小的尺度上具有很高的變化頻率,因此算繪結果容易出現強烈的走樣,而我們也需要處理這些細節的取樣問題
圖中的 Romanesco 也是自相似幾何的例子:整顆蔬菜具有許多尖錐狀的凸起,每個凸起又會包含更小的相似結構。 這種細節會在不同尺度上反覆出現,因此幾何表示與影像取樣都需要考慮觀察尺度
電腦圖學中的顯式表示法(Explicit Representations in Computer Graphics)
顯式幾何也有各種不同的表示方法,像是:
- triangle meshes
- Bezier surfaces
- subdivision surfaces
- NURBS
- point clouds
後面我們會再來一一介紹,首先從點雲開始
點雲(point clouds)
點雲會把物體表面的每個點都獨立表示出來,不像前面會以節點組成表面來描述一個物體。 這樣一來只要點足夠多,就能表示的足夠細緻,自然而然就看不到點與點之間的縫隙,也就形成表面了
一個點一樣會以空間中的
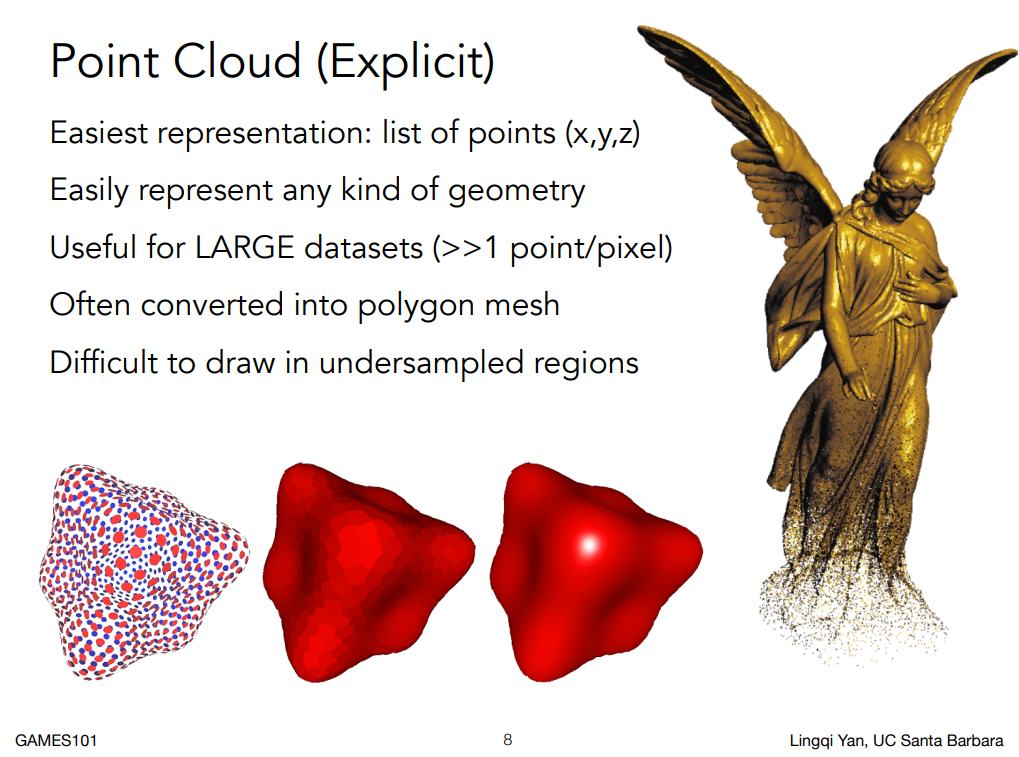
以右邊的雕像來說,你可以看到它上半部分的點雲密度非常大,因此我們可以很清楚的看到物體的表面。 接著慢慢往雕像的下半部分看,你會發現表面的中間已經開始有些縫隙,點雲的密度慢慢變得稀疏了。 到了最下面,你已經看不出面的存在了。 由此可見,我們如果要用點雲表現複雜且連續的表面,會需要非常非常多的點,因此人們通常不會直接使用點雲
但在做掃描建模的時候,得到的輸出都是點雲的形式,因此我們需要思考一個問題:要如何把點雲轉成三角形網格? 這有很多的研究在做(表面重建),但由於這邊偏介紹所以我們就不提了
多邊形網格(Polygon Mesh)
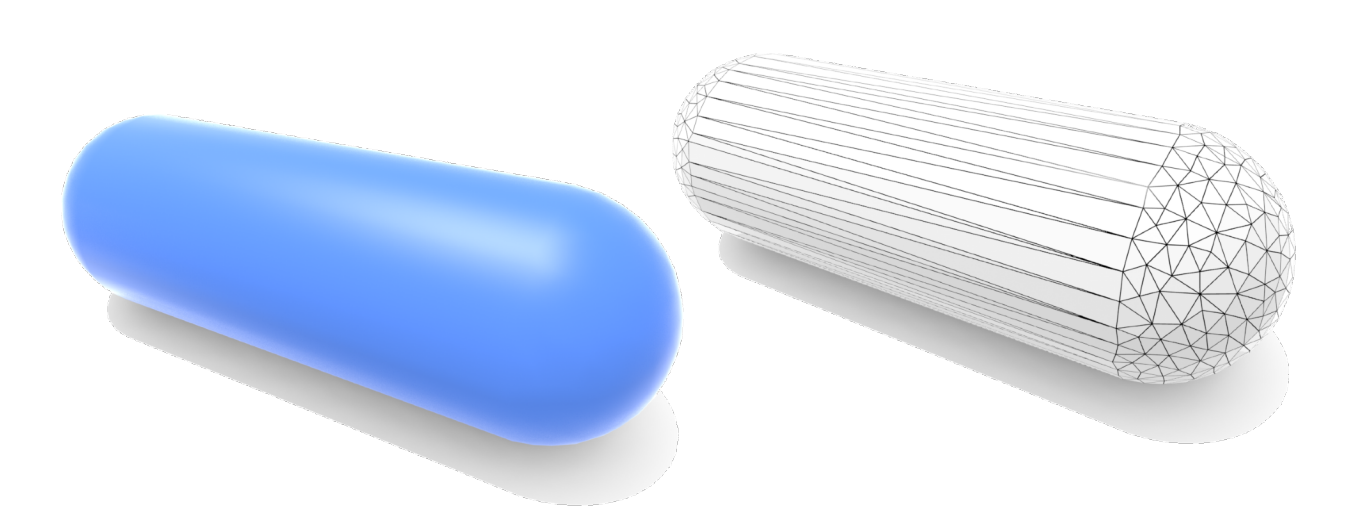
圖學中用得最多的是多邊形面,尤其是三角形或四邊形的面,通常我們會把任何的面都拆成各種小的三角形,以下圖為例,你可以看到球冠的部分用了許多的小三角形,而中間的部分則用了一些細長的三角形:
要用三角形去描述各種各樣的物體,最主要的問題就是三角形的連接關係,通常我們會用一些特定的文件格式來描述它,像是 wavefront object file,一般簡稱為 object file,後綴為 .obj,它是一個文本文件,裡面會把空間中的一堆點、法線和紋理座標分開來表示,然後再將它們組織起來,形成一個模型,看下面的例子:
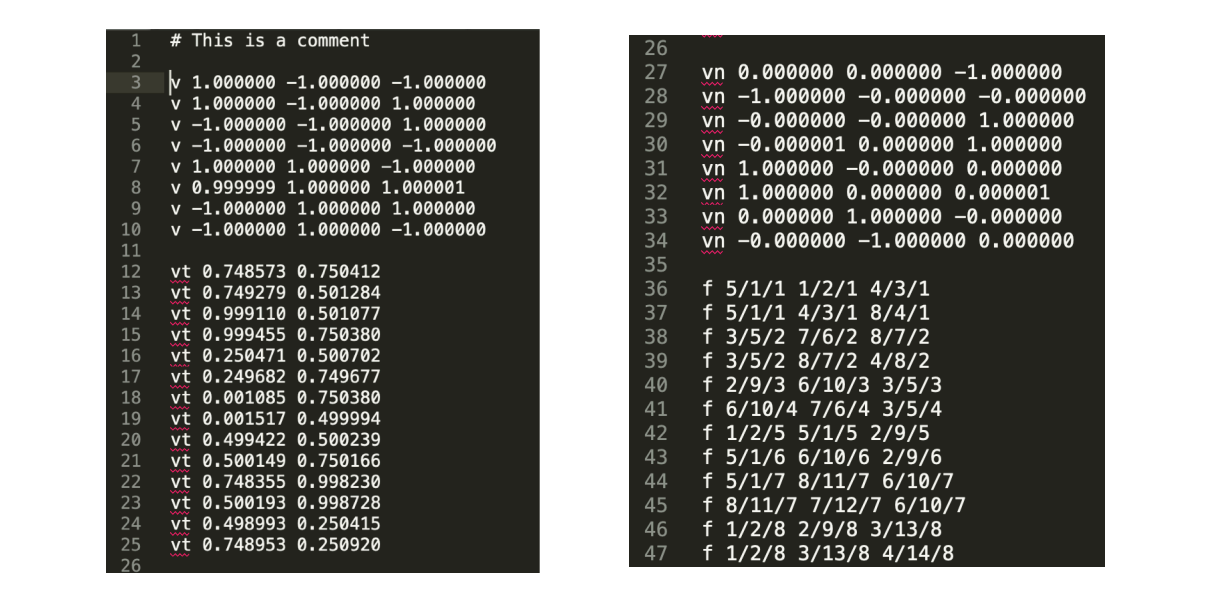
這個例子描述的是一個立方體,我們知道一個立方體共有八個空間中的點,我們用 v 來表示它,後面接對應的 x, y, z 座標。 而立方體有六個面,換句話說立方體有六個不同的法線,OBJ 會以 vn 來表示法線,這邊會有 8 行是因為這個是自動建模產生的檔案,所以會有一些冗餘。 vt 表示紋理座標,而 f 用來表示哪三個點會形成一個三角形。 具體的格式可以去看 wavefront object file format 的 spec
曲線(Curves)
貝塞爾曲線(Bézier curves)
我們接下來要看一個大重點:曲線。 無論是在動畫中描述相機的運動軌跡,還是在字體中描述彎曲的輪廓,都會需要曲線,因此曲線的應用非常廣泛。 這章會提一個很有名的曲線的顯式表示法:貝塞爾曲線(Bézier Curves)
貝塞爾曲線會用一系列的控制點去定義一條曲線的性質。 比如下面這個例子,曲線會從
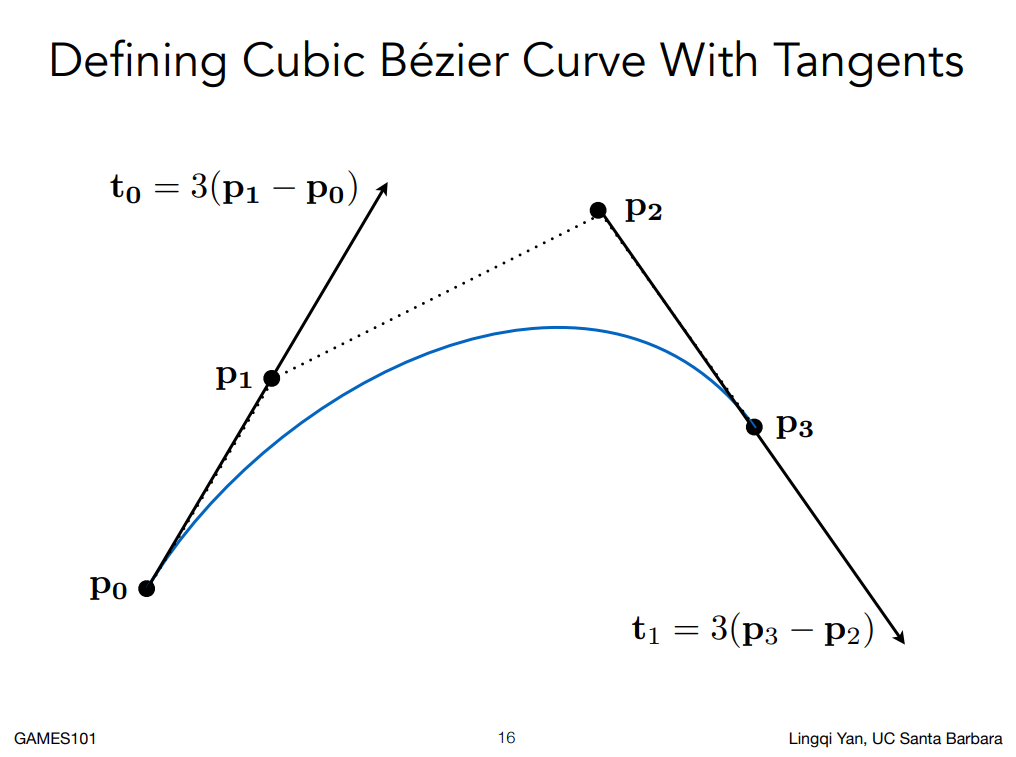
上圖中的參數式內有個係數「3」,這表示它對切線的長度也有定義,等等會再詳細解釋。 透過這四個控制點,我們可以確保這條曲線的起始點和終點一定會在
de Casteljau 演算法(de Casteljau Algorithm)
我們現在就來看如何用 de Casteljau Algorithm 來計算貝塞爾曲線上的點。 剛剛的圖裡面有四個控制點,但其實控制點的數量可以自己定義,現在假設我們只有三個控制點,如下圖:
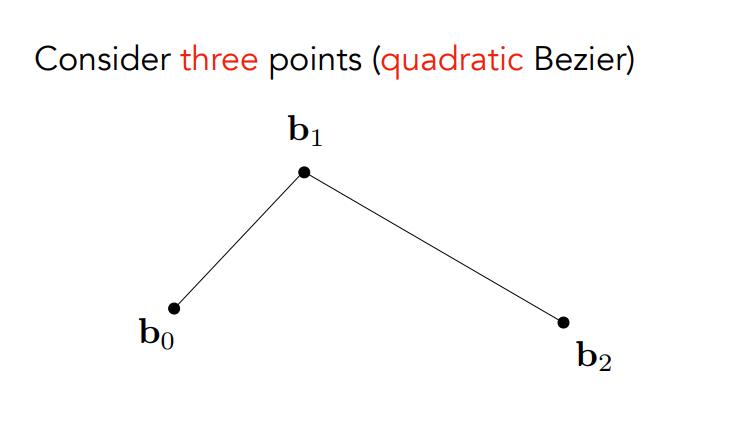
三個控制點生成的貝塞爾曲線有一個名稱,叫做二次貝塞爾曲線(Quadratic Bezier)。 從上圖你可以猜到,我們的曲線要從
de Casteljau 演算法會使用一個介於 0 至 1 的參數
de Casteljau 會在每條邊上用線性內插找出一個點,讓我們先以
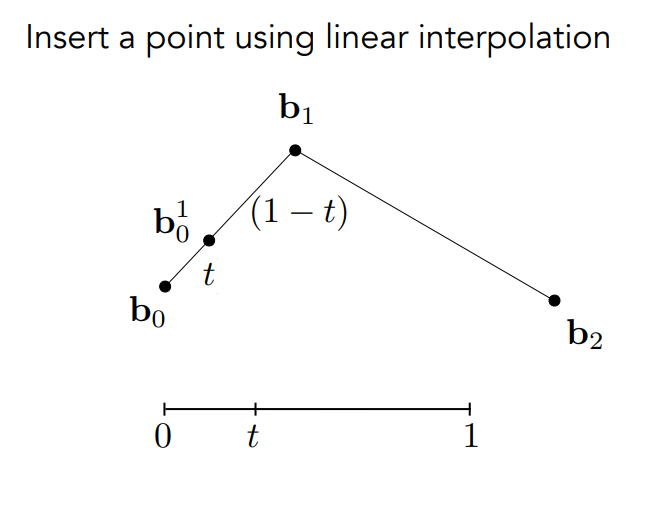
我們接著對另一條邊
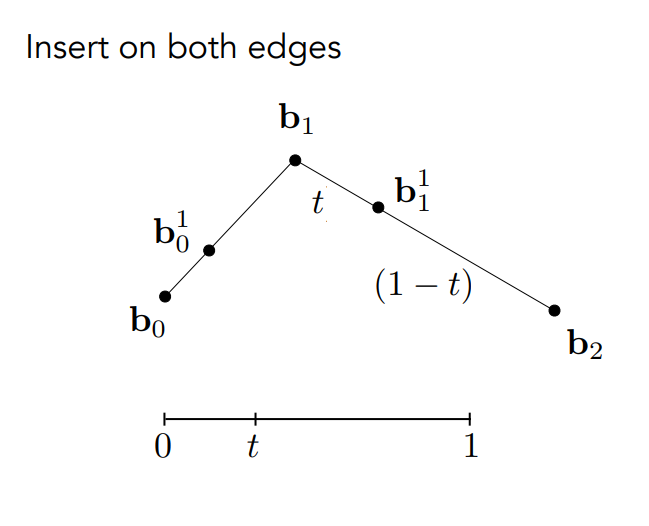
接下來把這兩個新得到的點連起來,再做一次內插:
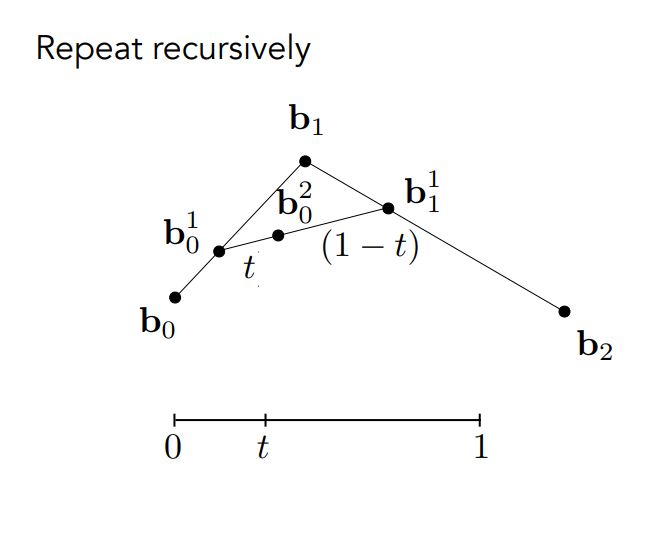
而因為不可能再有更多的線段了(剩一個點),因此這個點就是我們的輸出點了,這條貝塞爾曲線在時間
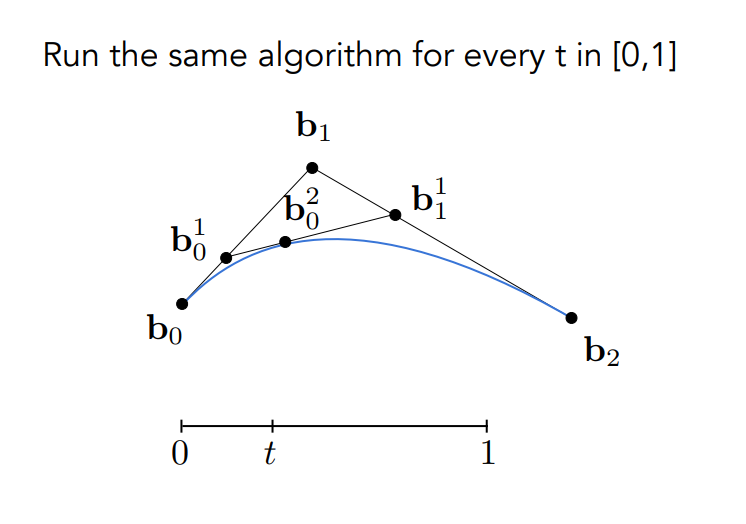
接著來看四個控制點的例子:
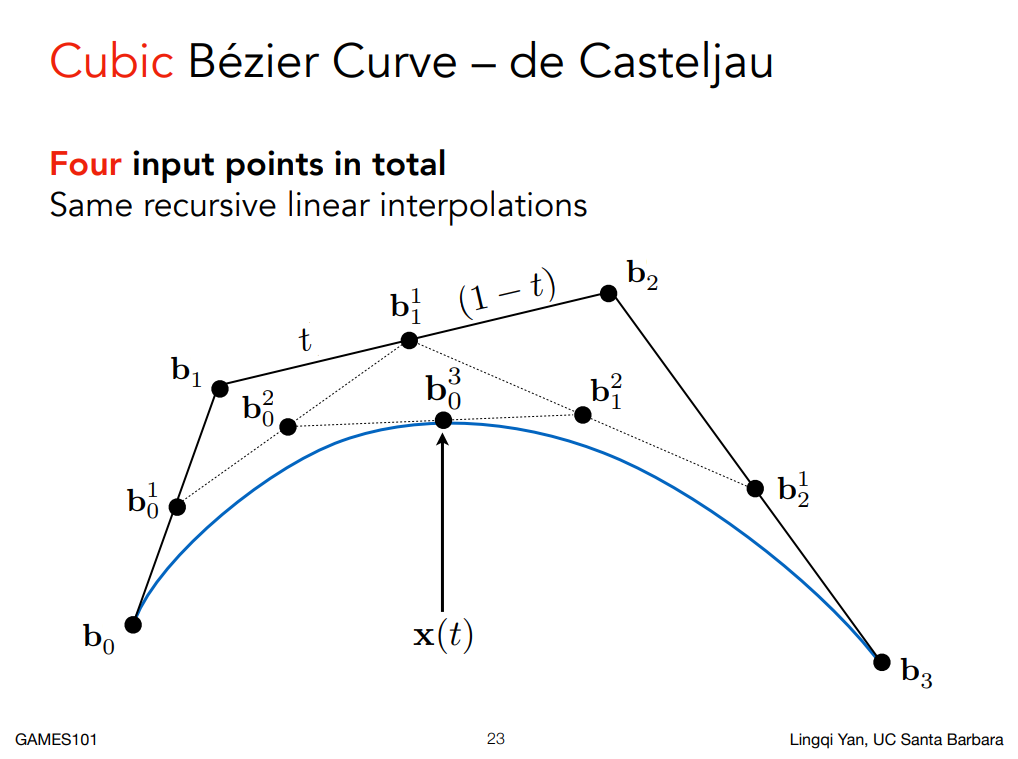
我們會沿用三個控制點的步驟,先在每條邊上找到內插點,再依序連接這些新點。 四個控制點原本形成了三條線段,第一輪內插會得到三個點與兩條線段,第二輪會得到兩個點與一條線段,最後一輪就會得到曲線在參數
貝塞爾曲線的代數求值公式(Evaluating Bézier Curves Algebraic Formula)
我們前面提到的是貝塞爾曲線的顯式表示法,現在讓我們來看它的代數形式。 由於貝塞爾曲線會由控制點來決定時間
假設控制點仍然是
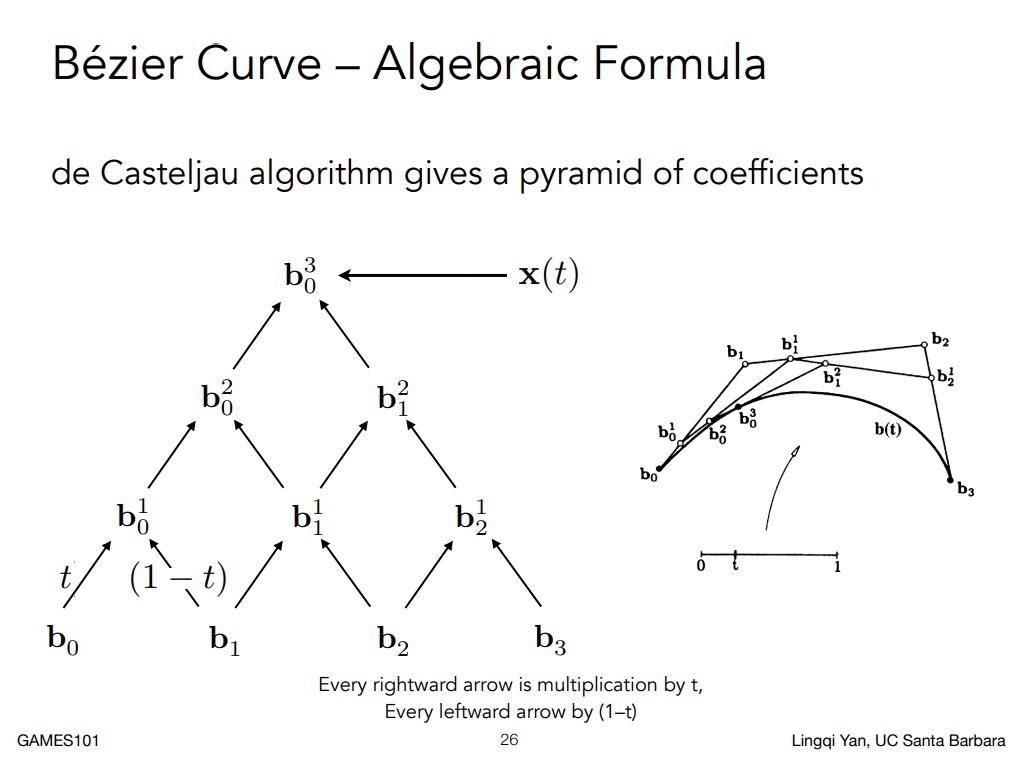
我們可以把所有層的計算統一寫成同一個遞迴式:
這裡的
讓我們再用一個三個控制點的貝塞爾曲線來幫助理解:
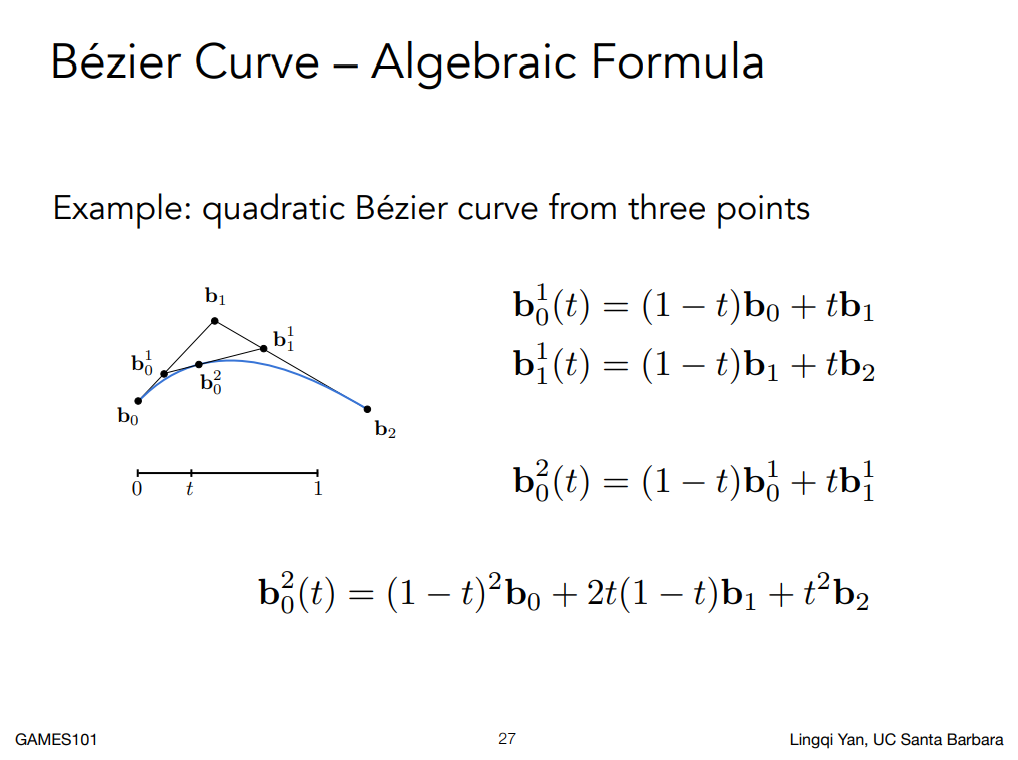
我們把兩層內插依序展開,就能得到二次曲線的式子了:
如果再增加一個控制點,可以進一步得到三次曲線的式子:
當我們我們依序展開各層的內插時,都可以得到其最後輸出點的參數式。 這些係數就是伯恩施坦多項式。 下圖列出了有
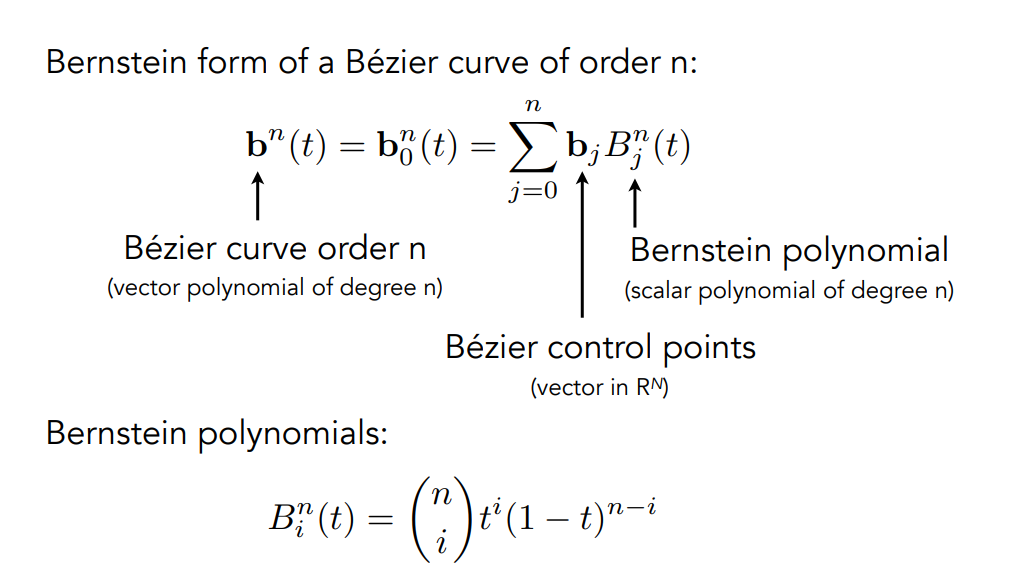
一般的
Bernstein 基函數在
因此,曲線上的每個點都會是控制點的凸組合。 這些權重同時具有
由於它的特性,我們其實也不用限定控制點要在一個平面上,下圖舉了一個在三維空間中的例子:
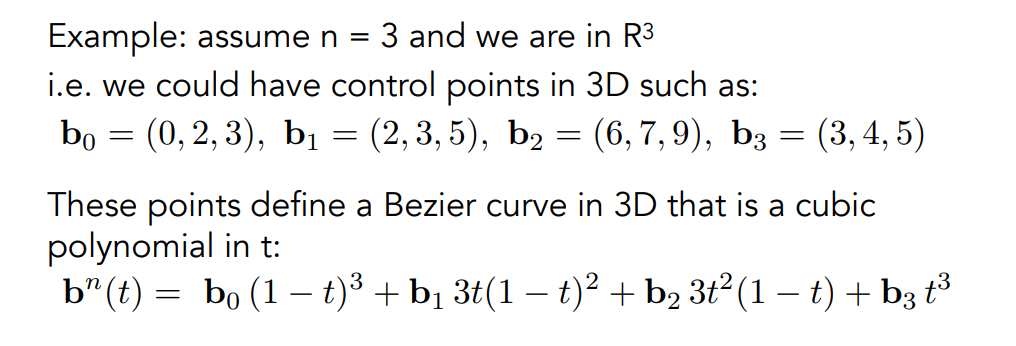
貝塞爾有一些不錯的性質,以四個控制點的曲線為例:
- 曲線在
- 起點與終點的切線向量可以直接算出來:
- 我們可以直接對控制點做仿射變換,而新控制點畫出的曲線,會與原曲線經過相同仿射變換後的結果一致
- 這個性質要求變換具有仿射形式,透視投影一般不符合這個條件
- 凸包性質(Convex hull):你畫出來的曲線一定會位在控制點形成的凸包內
提示
對整條曲線做的平移、旋轉或縮放等,也就是仿射變換
這代表我們可以藉由變換控制點來得到整條曲線的仿射變換結果。 上式的兩邊分別表示:
- 左邊:先用控制點算出曲線上的點,再對這個點做變換
- 右邊:先變換所有控制點,再用新的控制點算出曲線上的點
例如,把每個控制點都往右移動
這是因為,如果我們把權重簡寫成
權重總和等於一,讓平移量
現在要往右移動
- 先算出點,再平移:
- 先平移控制點,再算出點:控制點變成
關鍵是:第二種算法中,每個控制點加上的
可以看見因為權重總和等於
最後對於透視投影,因為它還要做類似
所以,直接投影控制點,再用原本的權重畫貝塞爾曲線,一般無法得到原曲線真正的透視投影結果
分段貝塞爾曲線(Piecewise Bézier Curves)
我們雖然可以使用任意多個控制點,但當控制點的數量上升後,曲線的形狀就不容易直接從控制點看出來了。 另外,控制點的數量一多,我們也會變得不容易預測各個控制點對整段曲線的影響,比較難直接調整出想要的形狀。 底下是一條
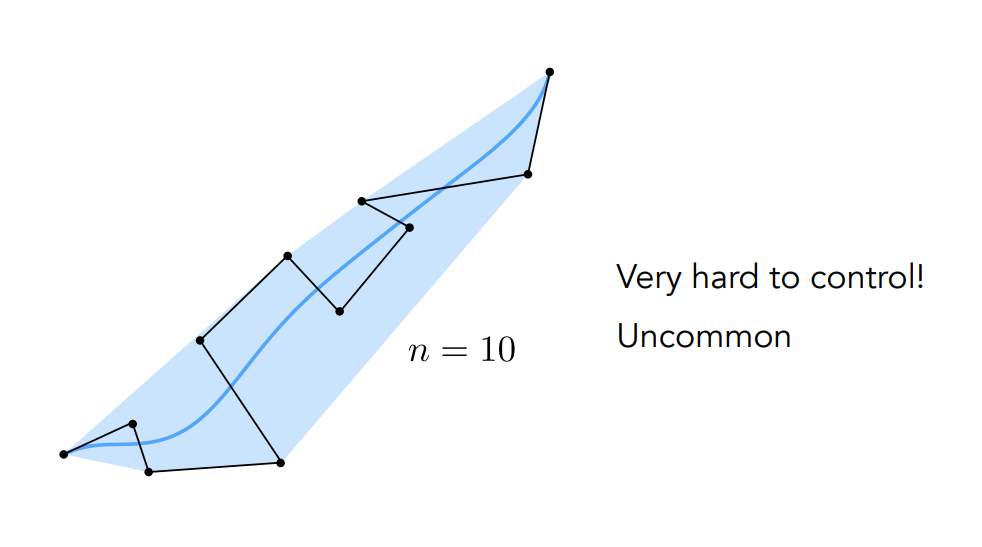
你可以看到它變得十分平滑,不利於使用控制點來取得你想要的形狀。 為了更好的操控貝塞爾曲線,人們使用了逐段(piecewise)的方法,利用多組使用三、四個控制點的貝塞爾曲線來組合出一個想要的曲線:
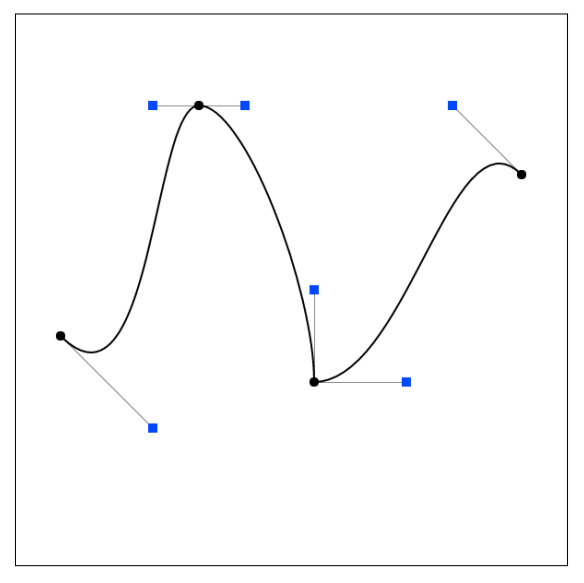
曲線在連接處可能會有轉折,如果要保持曲線的光滑,由於前面提到的貝塞爾切線的特性,你需要讓連接處的三個控制點共線,且和兩段的控制線段的長度是一樣的,這樣才能有
我們可以用兩段三次曲線
- 左段
- 右段
想像一個點先沿著
讓
但只有位置重合,接點處仍可能出現「第一段從左邊抵達,第二段突然往上走」的尖角。 而
這兩個向量要相等,就必須滿足:
兩邊除以
意思是:從
從
把等式整理一下:
因此共同接點
例如,
提示
一階導數描述「位置隨參數
因此,符合
圖學中還有一些其他的曲線,例如 Spline,它是一種曲線的類別,也會有一系列的控制點,並能滿足一定的連續性。 其中用的比較多的是 B-splines,其中的 B 為 Basis 的縮寫,指基函數,所謂的基函數就類似我們剛剛的伯恩施坦多項式
B-splines 類似於對貝塞爾曲線的擴展,能力比貝塞爾曲線更強,可以讓我們用較低次數的分段多項式,組合出由許多控制點決定的曲線。 我們剛剛看到的高次貝塞爾曲線,會因為一個控制點的移動而改變整段曲線的形狀。 但設計者往往希望一次只修改某個控制點附近的區域,而 B-splines 的基函數具有局部支撐,因此 B-splines 就能提供這種局部控制
雖然其與貝塞爾曲線的方法非常類似,不管是從幾何角度,還是代數角度,它們的分析方法都類似,只是 B-splines 的幾何數更加複雜而已。 但由於這門課是入門課,所以這裡就不提了。 另外要再更進一步的曲線還有 NURBS,這邊就只提個名詞,不多做著墨了,有興趣的可以看看清華胡志明老師的課程
曲面(Surfaces)
接著我們來討論曲面。 我們可以把前面的參數曲線延伸成參數曲面,讓兩個參數共同決定三維空間中的一個點
貝塞爾曲面(Bézier Surfaces)
貝塞爾曲面的概念與貝塞爾曲線類似,一樣會有一系列的控制點,例如下圖有 16 個控制點:
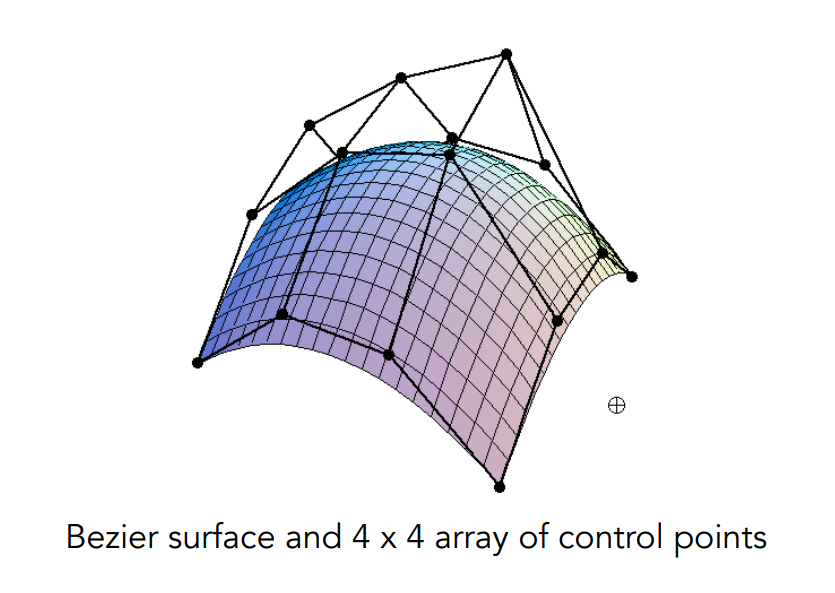
我們可以仿照雙線性內插的想法,在兩個參數方向各做一次貝塞爾曲線的計算。 下圖的控制點會排成四列,每列有四個控制點。 我們會先得到四條灰色的貝塞爾曲線,接著再對這四條曲線使用同一個參數
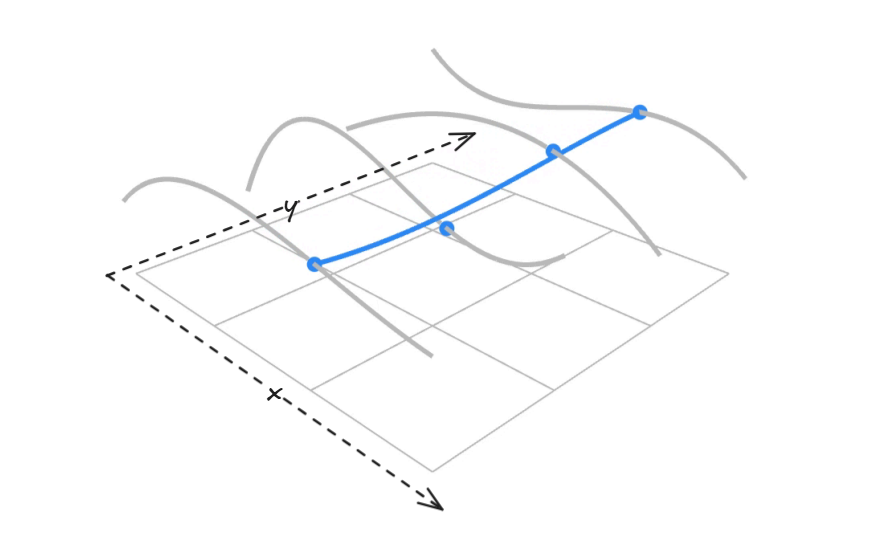
老師的上課錄影中有個 demo 影片,但我找不到下載的網址,具體來說可以看這段影片,看完影片應該會比較好理解。 另外由於有兩個方向,因此也需要有兩個
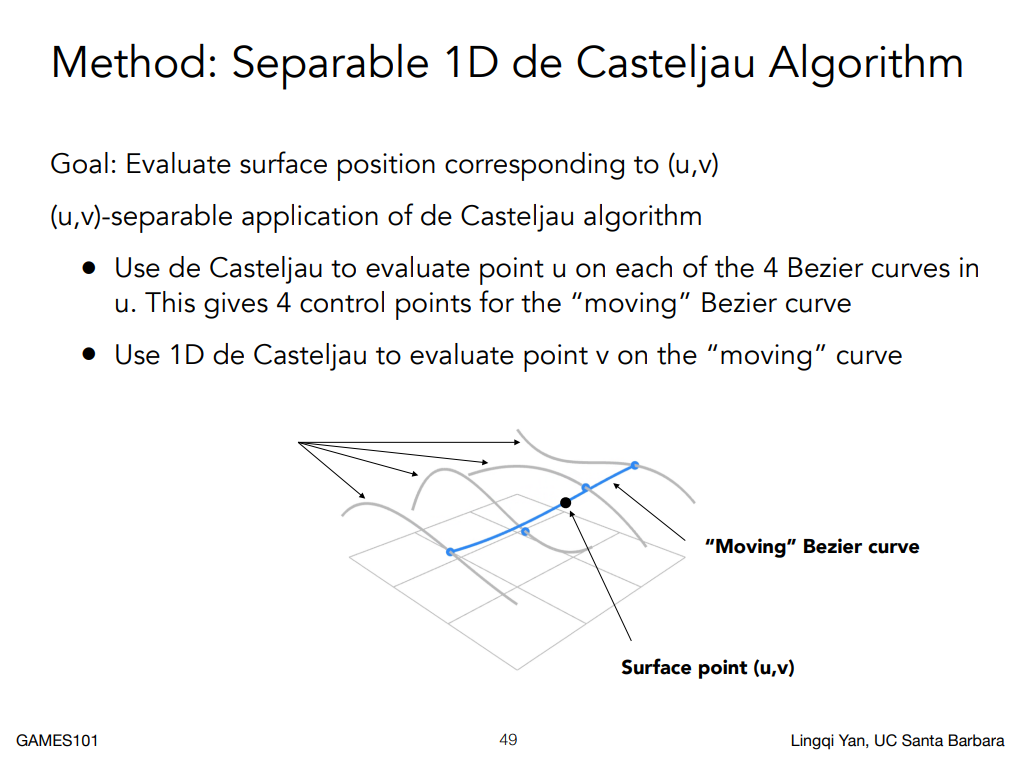
如果把控制點記為
這個式子會把平面參數
網格操作:幾何處理(Mesh Operations: Geometry Processing)
前面的貝塞爾曲面會從控制點定義連續曲面,三角形網格則會直接保存頂點與連接關係。 當我們已經有一個網格時,我們通常還會需要三種幾何處理操作:
- 網格細分(mesh subdivision):用來增加面與頂點的數量,並調整頂點位置,讓表面逐漸變得光滑
- 網格簡化(mesh simplification):用來減少面與頂點的數量,並盡量維持原本的形狀
- 網格規則化(mesh regularization):用來改善三角形的形狀與分布,讓網格減少過尖、過長的三角形
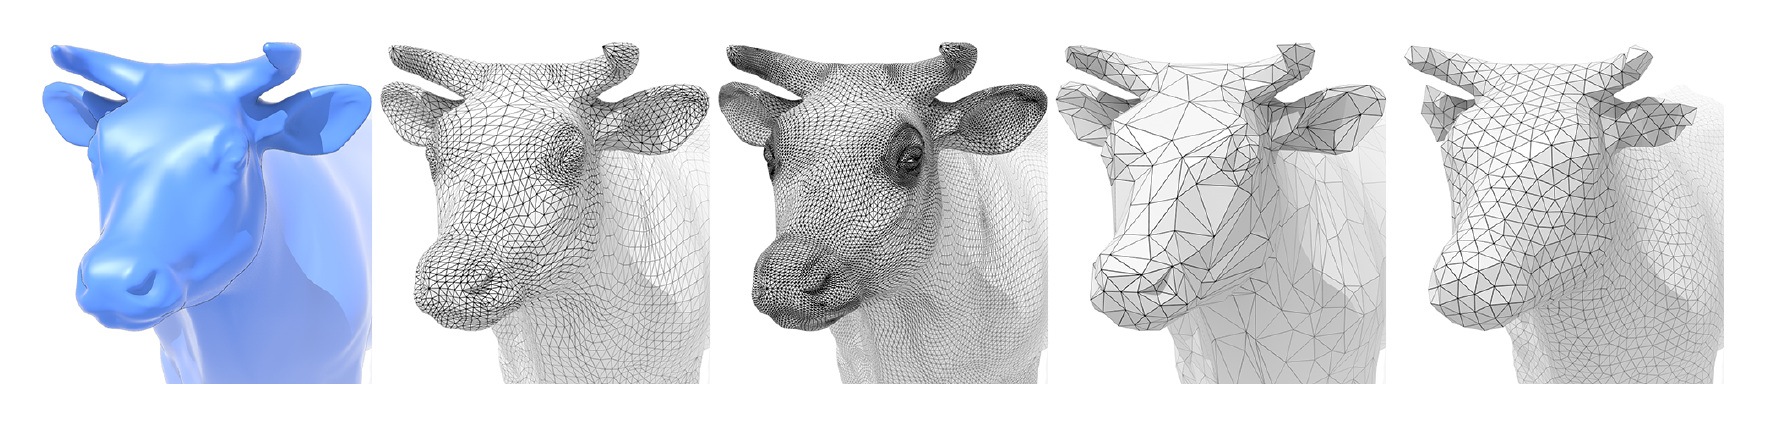
細分會讓原本粗糙的網格變得更密,簡化會讓模型使用更少的三角形,規則化則會讓各個三角形的尺寸與形狀更接近。 我們在改善網格品質時,也需要保留耳朵、牛角等幾何特徵,否則規則的三角形仍然可能組成失真的模型
網格細分(Mesh Subdivision)
我們在位移貼圖裡已經遇過了細分的需求:高度紋理會描述細小的凹凸,但粗大的三角形只有少量頂點,模型因此無法反映這些高度變化。 增加頂點後,位移貼圖才會有足夠的位置可以移動
這裡的細分曲面還會多做一件事:細分演算法會調整新舊頂點的位置,讓表面逐漸變得光滑。 如果我們只是在一個平面上的三角形裡增加更多三角形,那所有的新頂點仍然會落在原平面上,物體的外形會因此完全沒有改變
Loop 細分(Loop Subdivision)
Loop subdivision 適用於三角形網格,其中 Loop 是提出這個方法的人的姓氏,不是說它這個方法跟迴圈有關。 這個演算法會重複執行兩個步驟:先把每個三角形拆成四個三角形,再依照不同的權重更新頂點位置
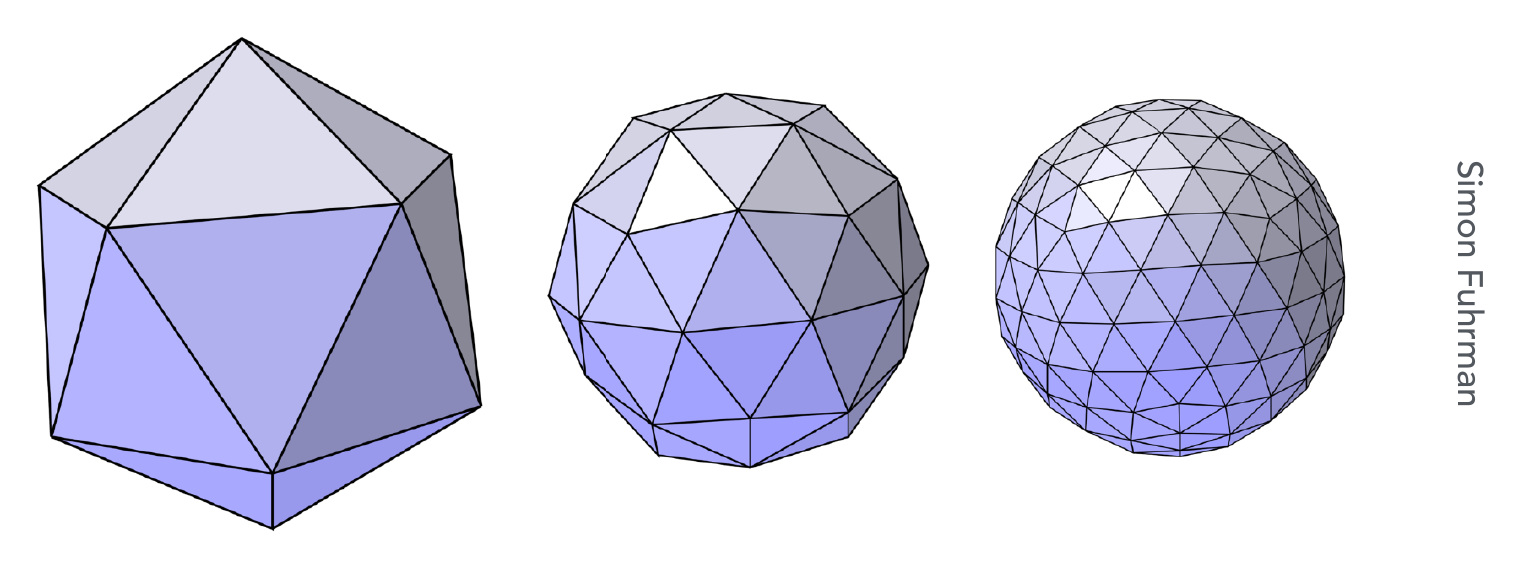
我們可以先在三條邊上各放一個新點,再把這三個點連起來。 如此一來,原本的大三角形就會被拆成中央的一個三角形,加上周圍的三個三角形,總共就有四個三角形了
新頂點的位置
我們先考慮網格內部的一條邊
邊的兩個端點會各占
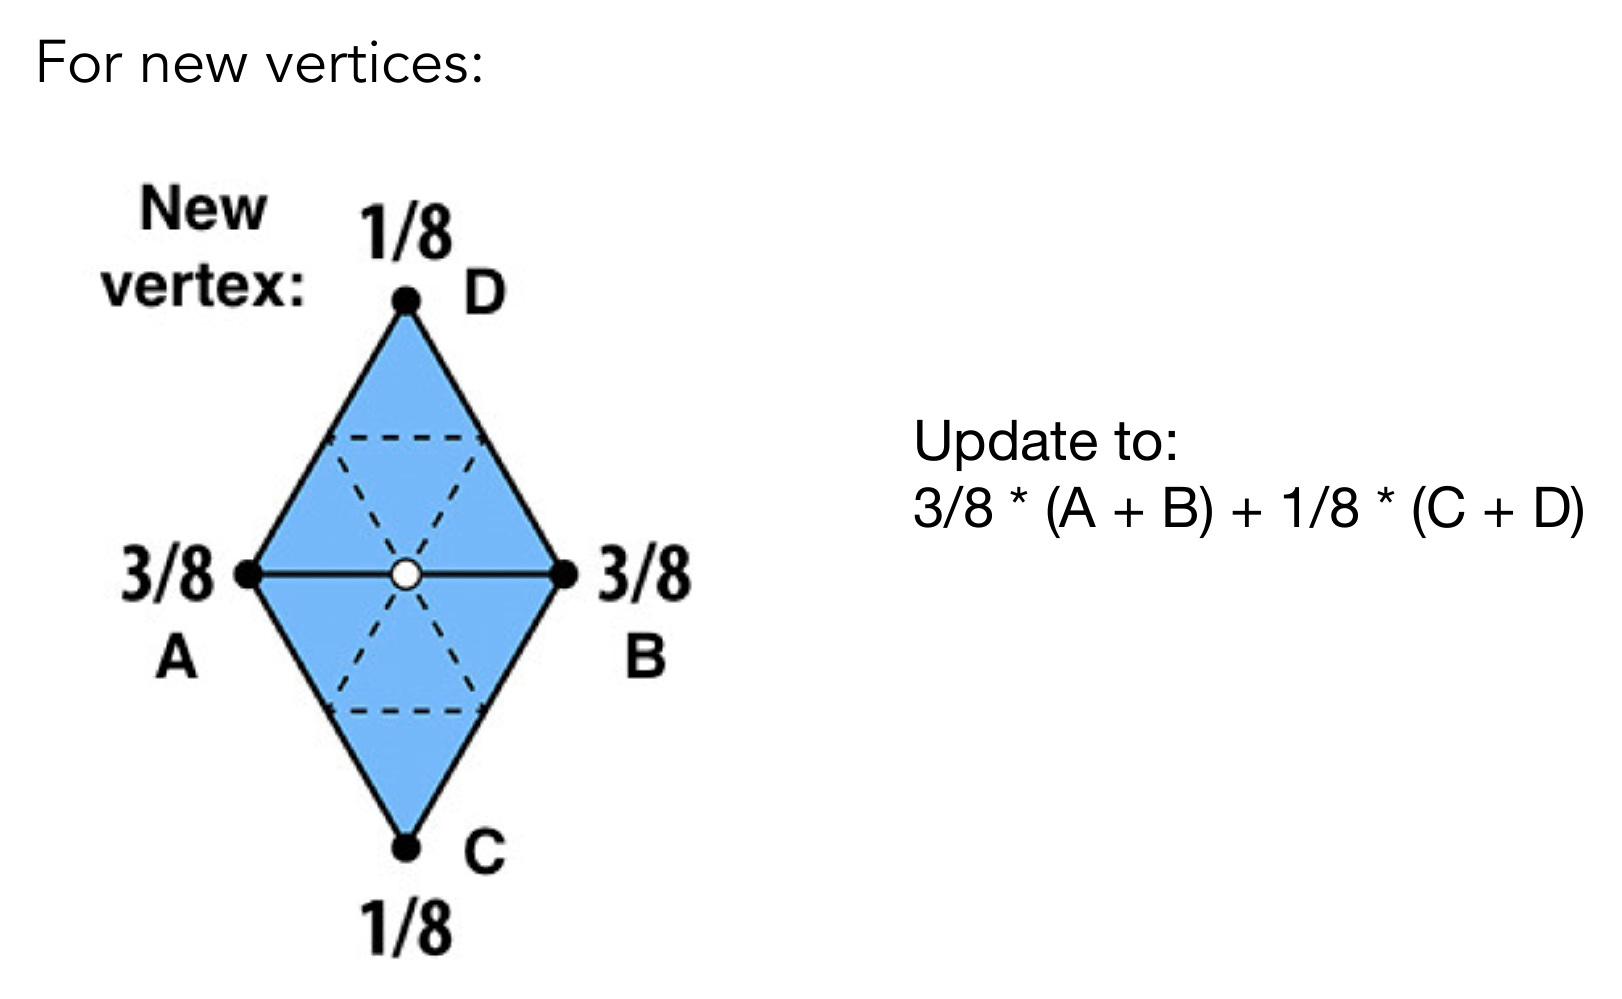
舊頂點的位置
接著讓我們來更新原本就存在的頂點。 假設舊頂點為
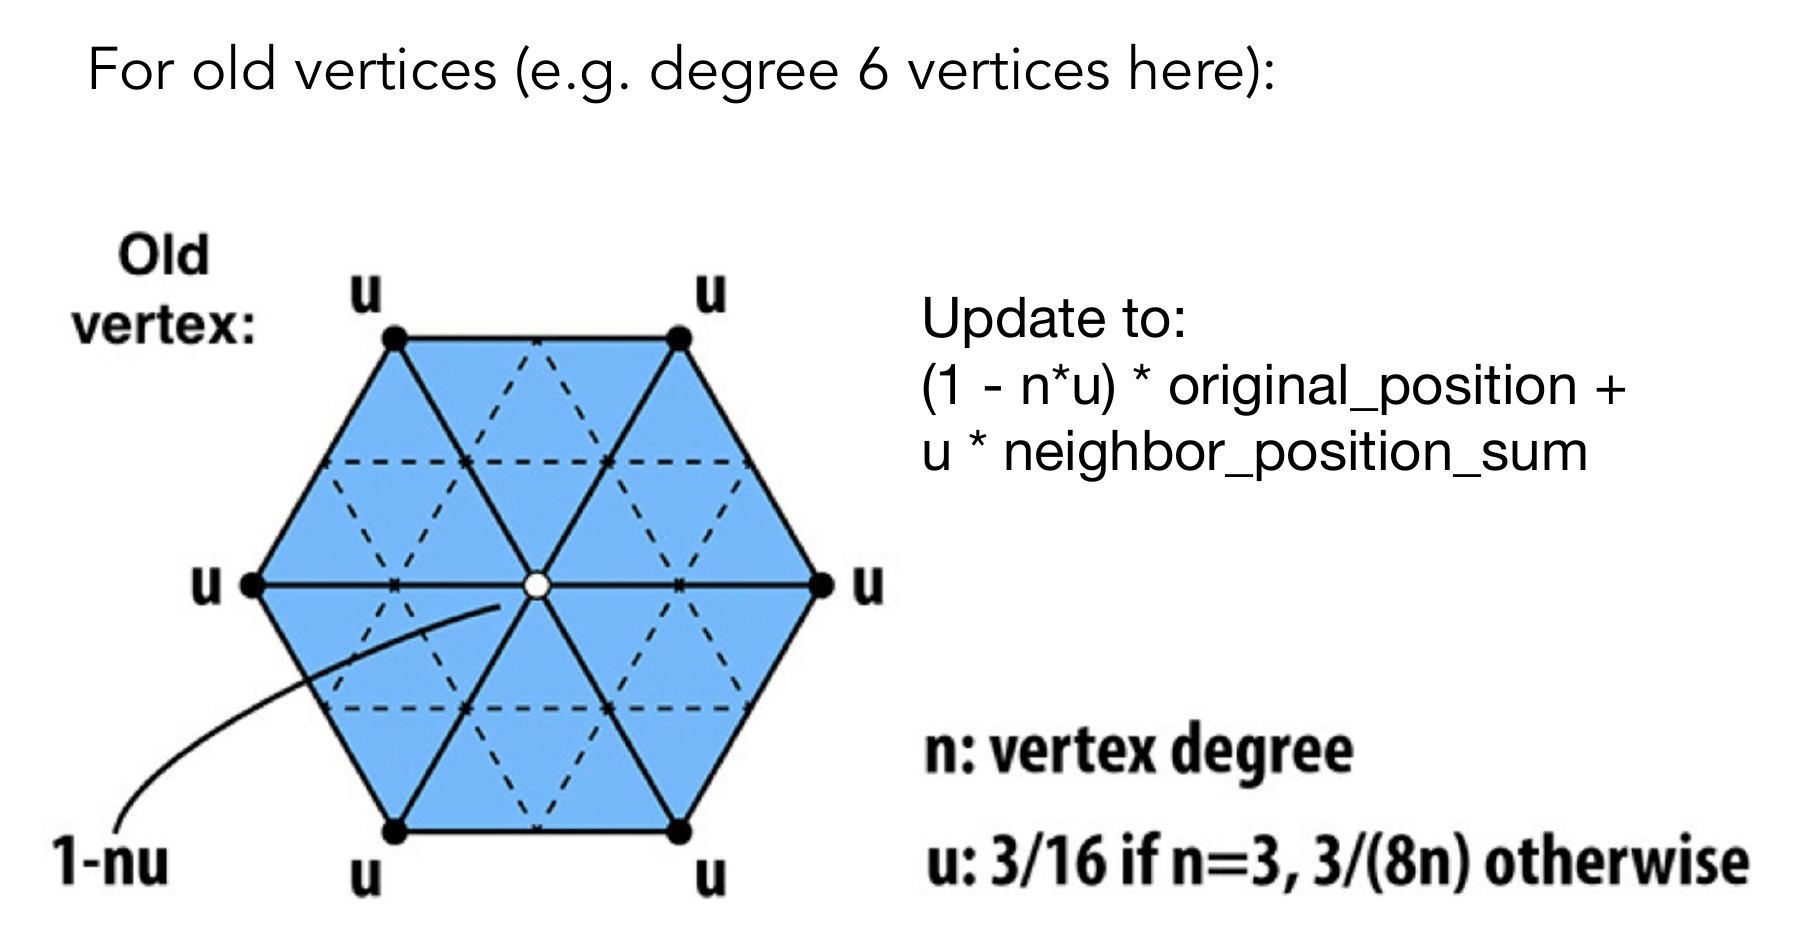
這裡的
例如,圖中的頂點具有六個鄰居,所以
我們在每一輪更新中,都會使用該輪開始前的舊頂點資料。 如果我們邊算邊覆寫,再讓後面的點使用已經更新的位置,結果就會受到走訪順序的影響,也就不再符合上面的更新規則了
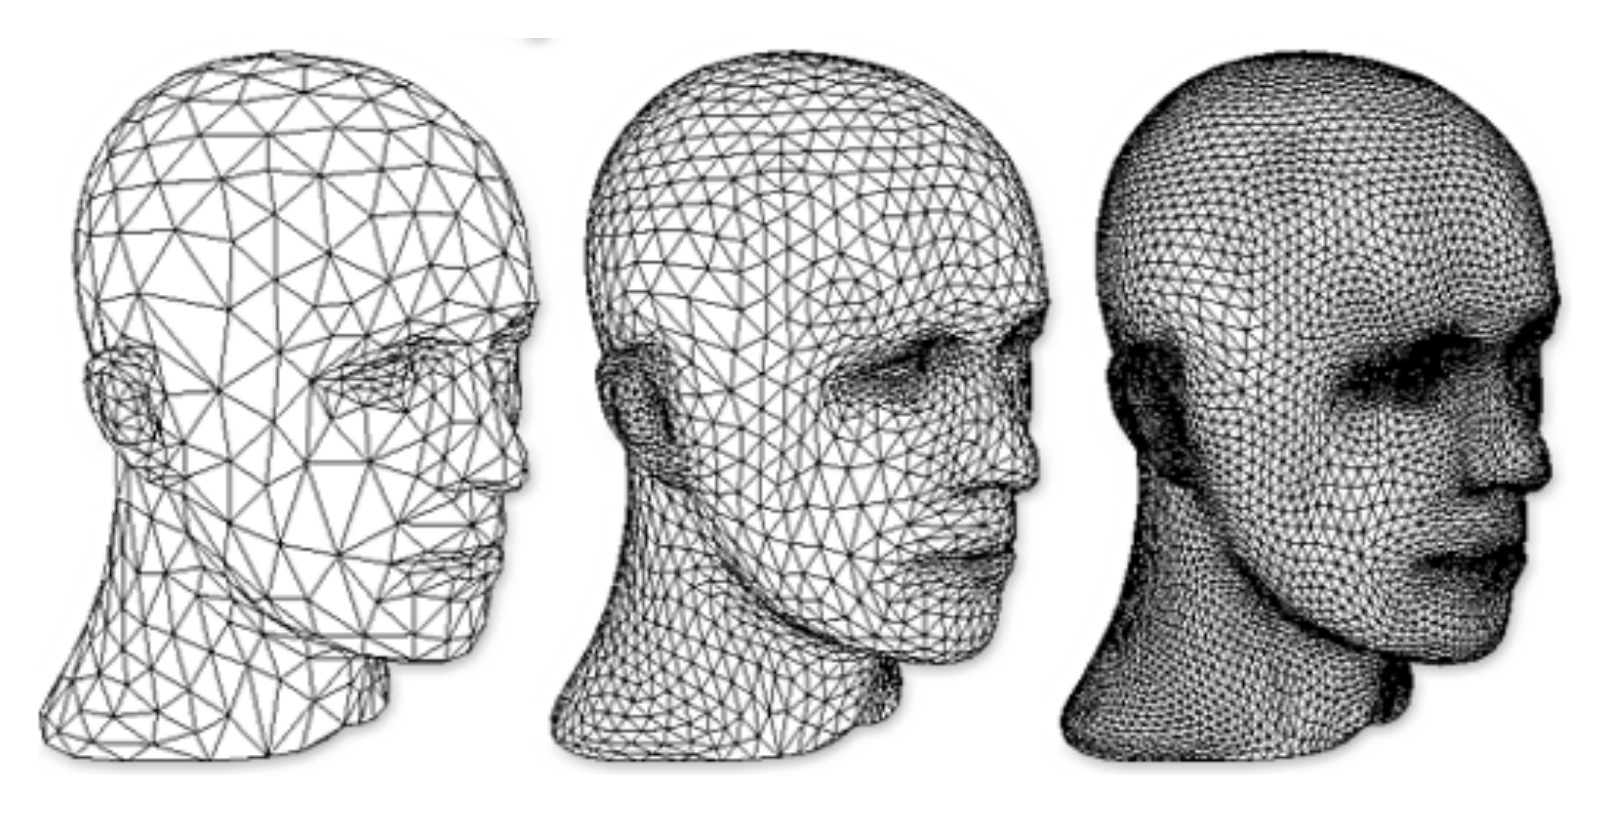
圖中的三角形數量每輪都會增加為原來的四倍,而新舊頂點的位置也會一起改變。 因此,模型會逐步接近一個平滑的曲面,原本明顯的稜角也會變得圓滑
Catmull-Clark 細分(Catmull-Clark Subdivision)
Loop 的拆分規則以三角形為前提,但建模時的網格也可能會同時包含三角形、四邊形或更多邊的面。 此時我們可以使用 Catmull-Clark subdivision,它可以處理這種多邊形網格,並在第一輪細分後把各個面都轉成四邊形
我們先認識兩個會用來分析拓樸的名稱:
- 非四邊形面(non-quad face):邊數不等於四的面
- 奇異頂點(extraordinary vertex):度數不等於四的頂點
- 這裡的「奇異」只是在描述它與規則四邊形網格不同的連接數量
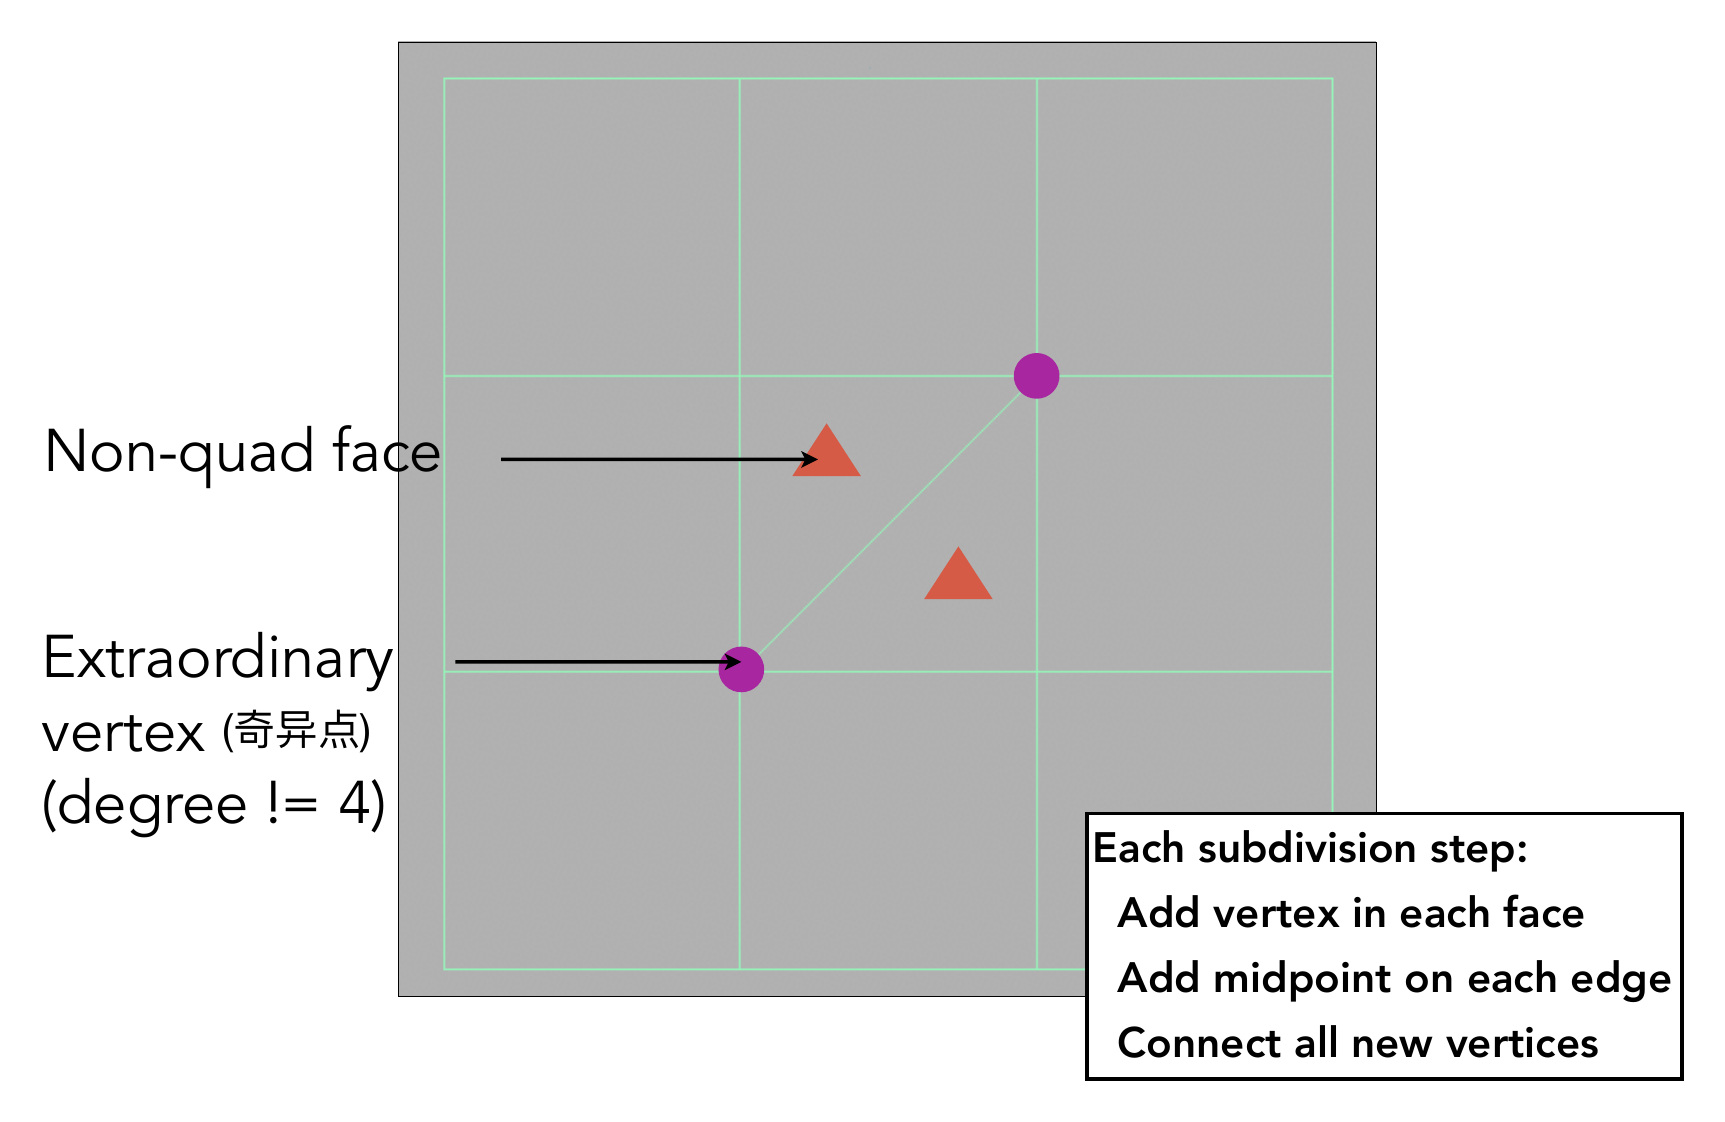
圖中紫色的兩個舊頂點各連了五條邊,所以它們都是奇異頂點。 兩個橘色標記則指出了非四邊形面,也就是中央的兩個三角形
細分後的連接關係
Catmull-Clark 會在每個面裡面新增一個面點,並在每條邊上新增一個邊點。 接著會把面點連到這個面的所有邊點,再保留各個舊頂點與相鄰邊點的連線,此時舊面的每個角落就會對應到一個新的四邊形了
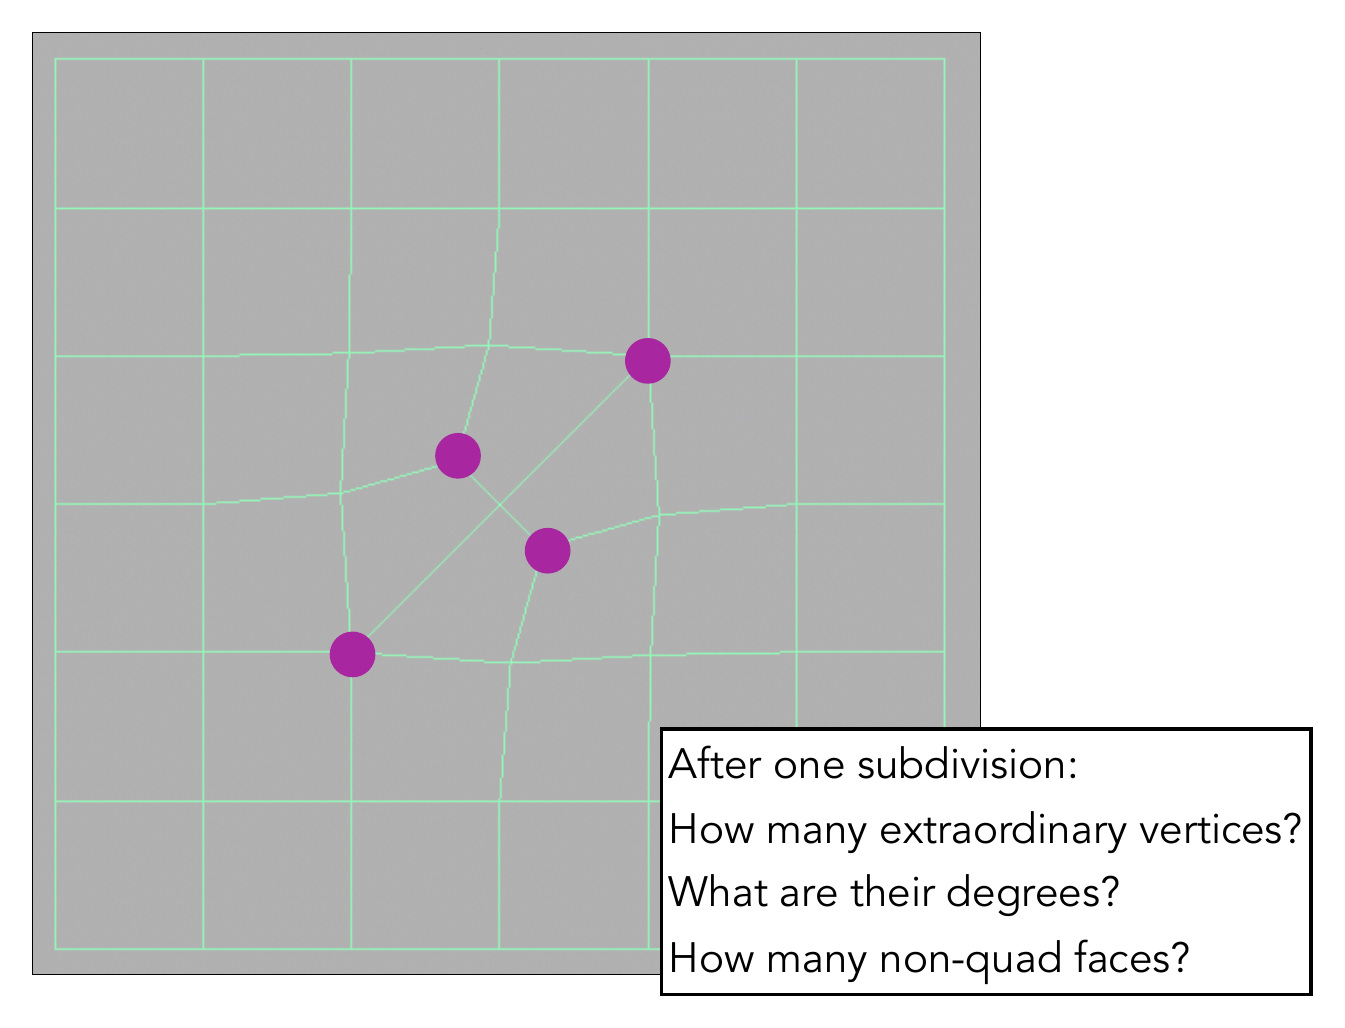
例如,三角形會拆成三個四邊形,五邊形會拆成五個四邊形。 由於每個新四邊形都會依序經過「舊頂點、邊點、面點與另一個邊點」,所以舊面的邊數不會改變新面具有四個角的事實
現在來看一下圖中奇異頂點的數量。 原本兩個度數為五的頂點仍然各連五條邊,而兩個三角形內的面點各連三個邊點,所以這一輪一共會出現四個奇異頂點。 一般來說,一個
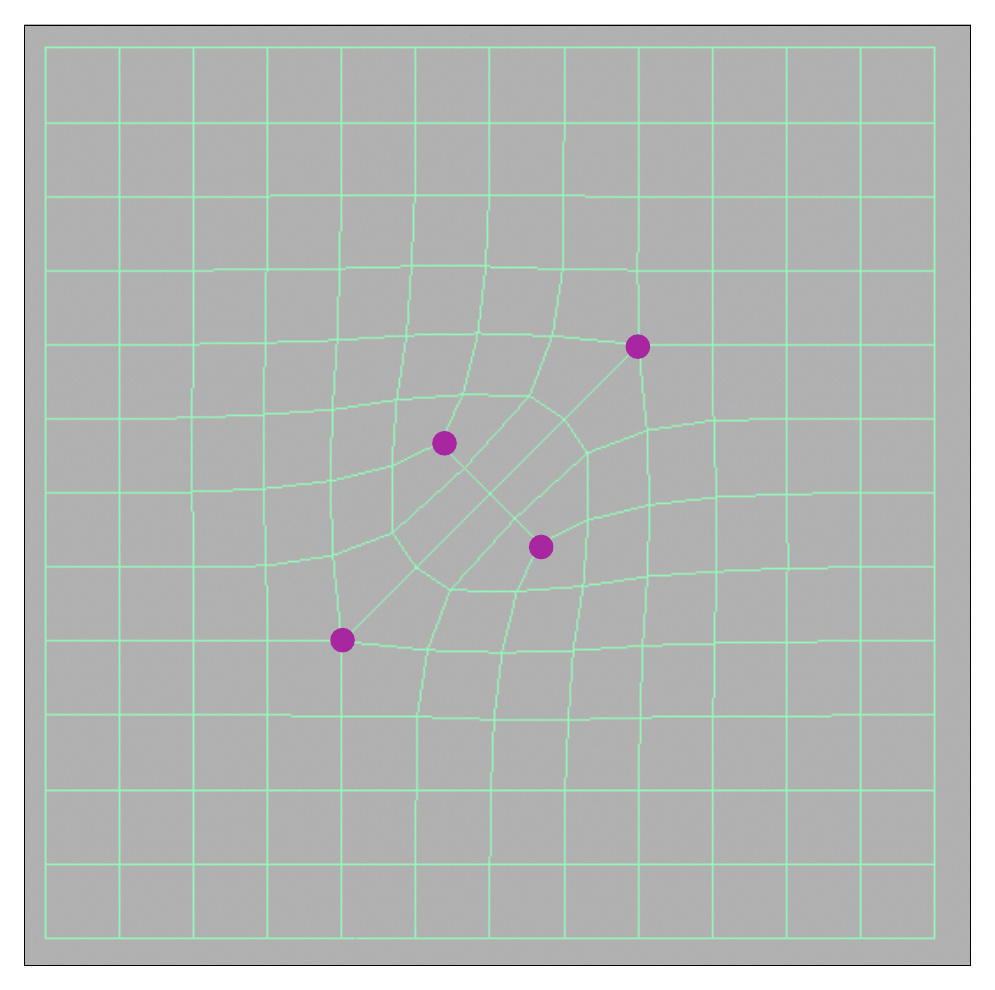
第一輪結束後,所有的面就都已經是四邊形了。 之後新產生的面點各會連著四條邊,而內部邊點也會各連著四條邊,因此後續細分不會再因為非四邊形面而增加奇異頂點了。 舊奇異頂點的度數則會維持原值
面點、邊點與舊頂點的更新
上一節我們講了需要那些點以及線要怎麼連,現在我們來看一下這些點的位置要怎麼算。 我們先計算每個面的面點,其位置是這個面裡面所有舊頂點的平均。 如果這個面有
接著是內部邊,假設邊的兩個舊端點是
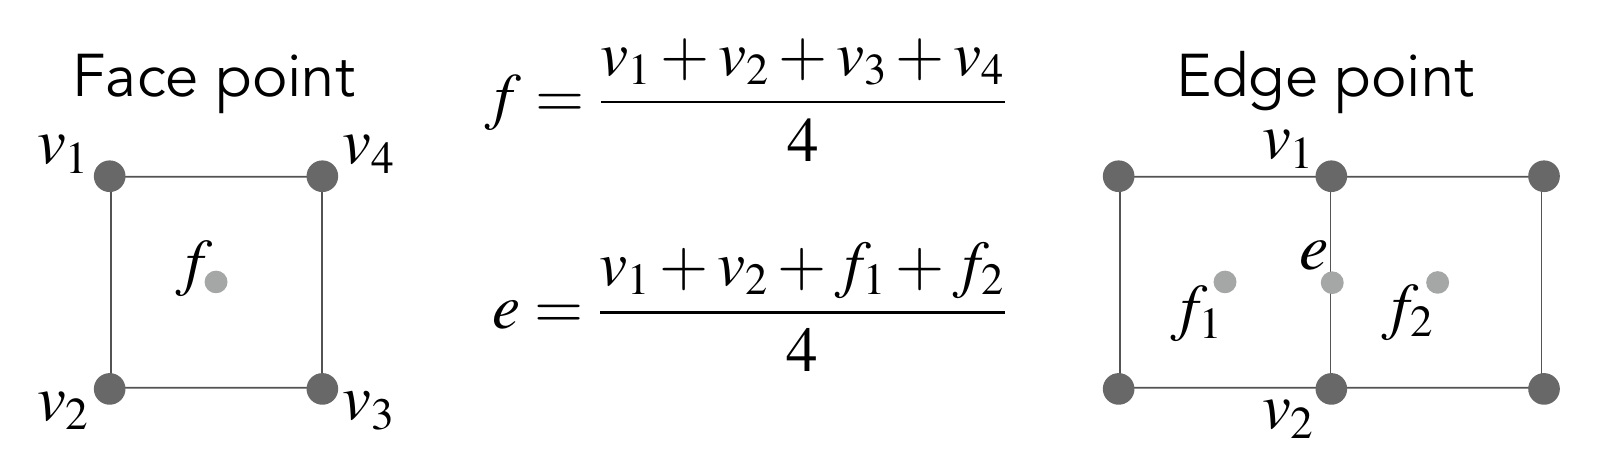
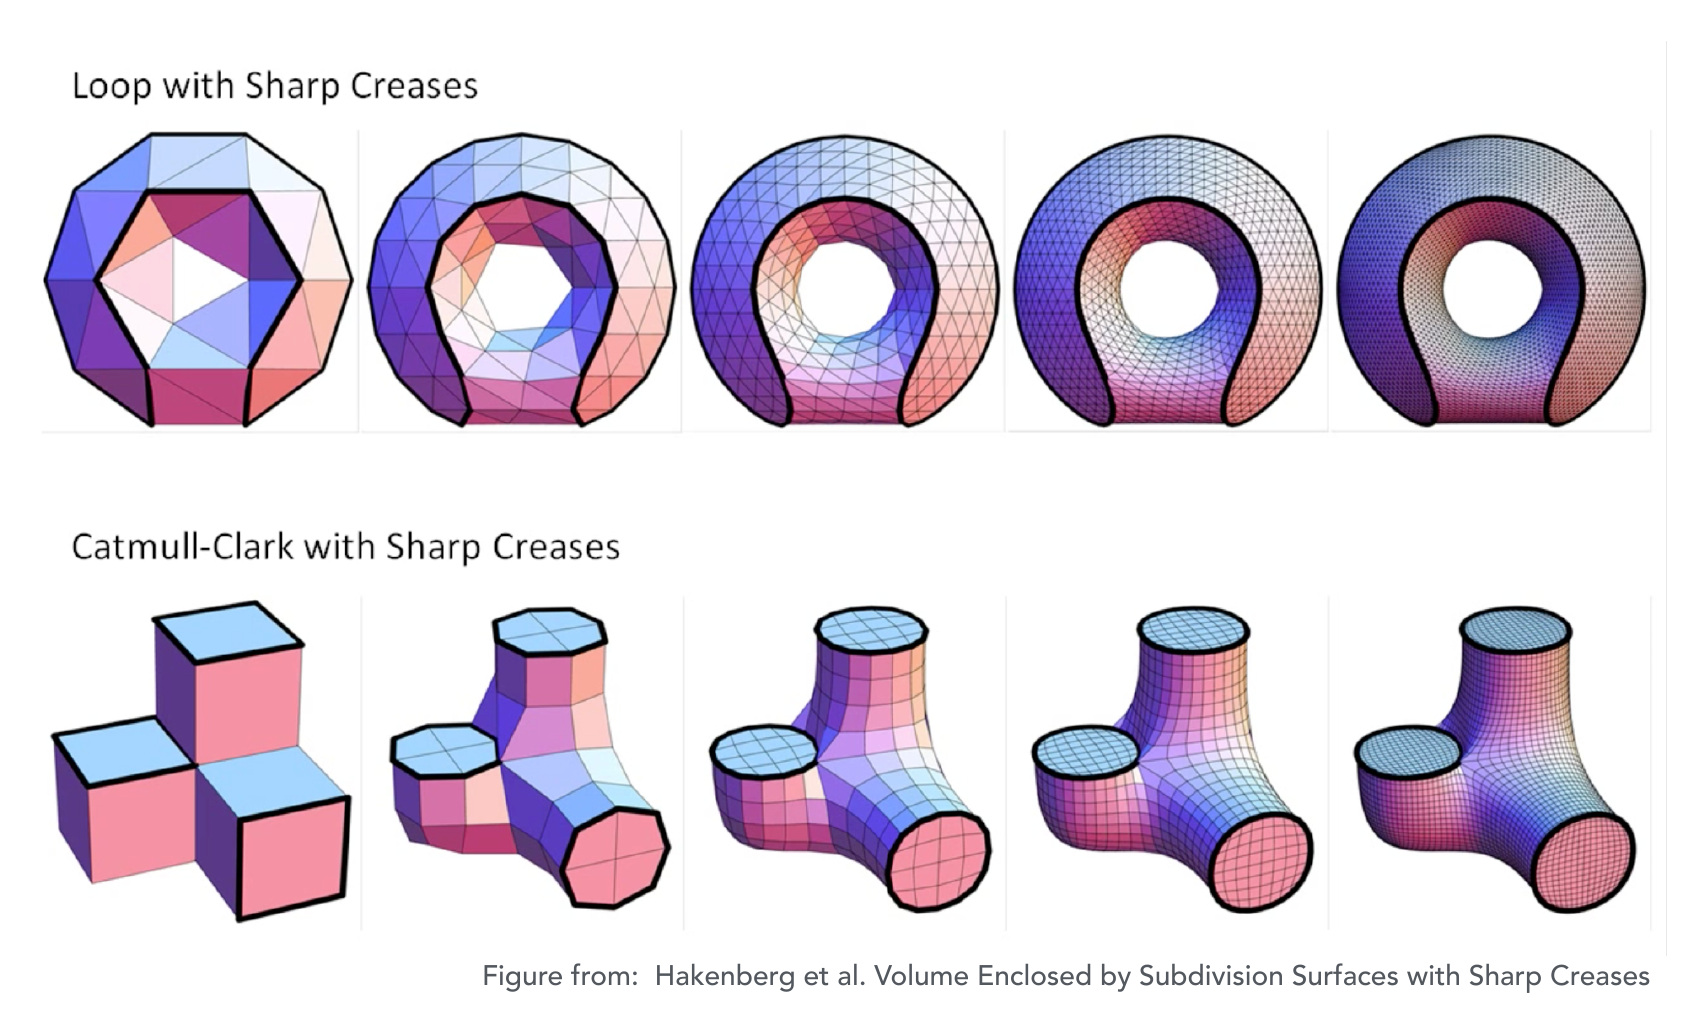
最後是舊頂點的更新。 以頂點度數為四的四邊形網格來說,假設
這裡的
其中
網格簡化(Mesh Simplification)
我們在觀察遠處物體時,通常都看不到高密度模型的細節,此時我們可以利用網格簡化來幫助減少不必要的運算。 網格簡化會在減少面數的同時,盡量保留物體的整體形狀,以降低頂點變換、幾何處理與儲存的成本
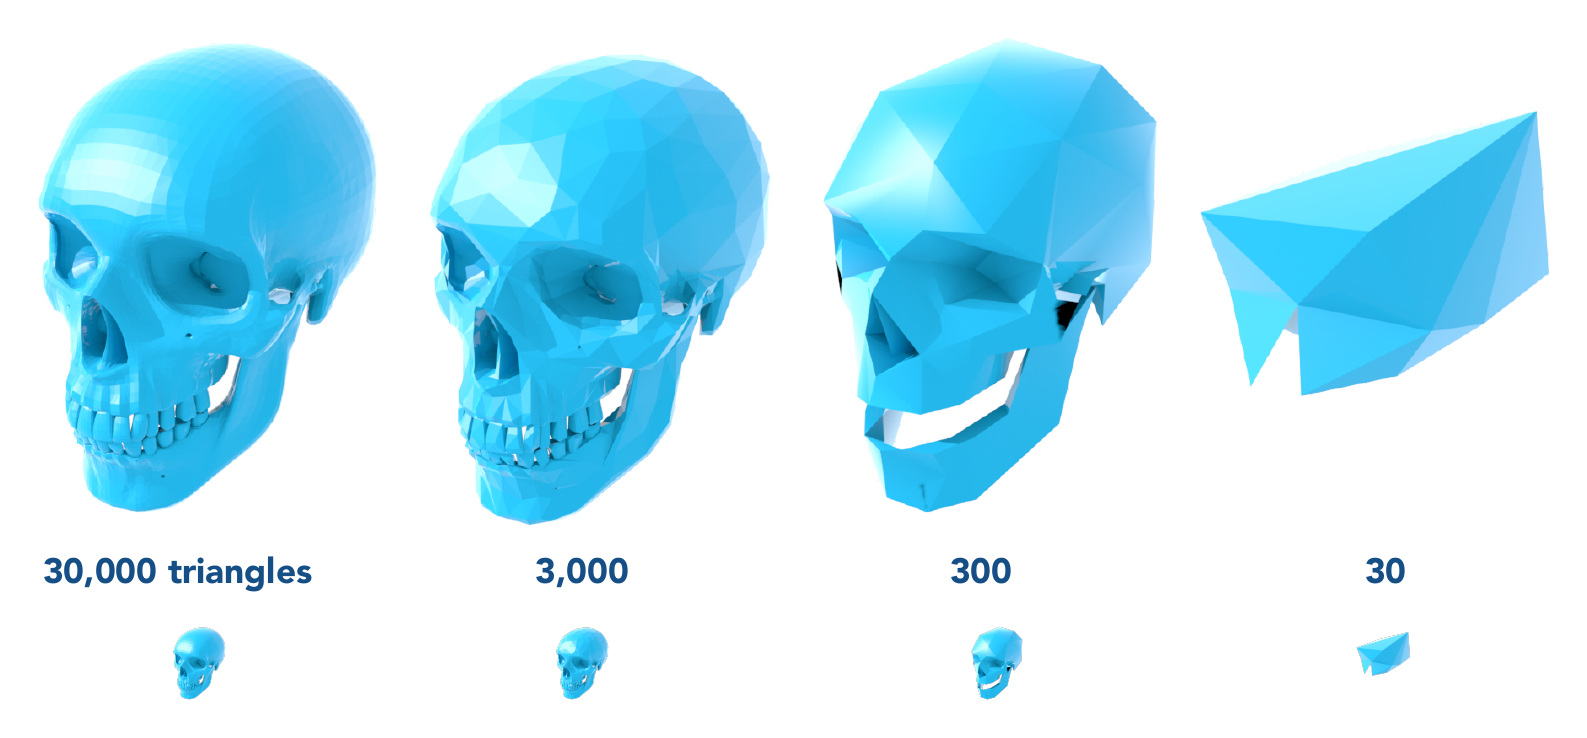
圖中的骷髏依序使用了 30,000、3,000、300 與 30 個三角形。 對於前兩者,我們尚有辦法看見逐漸消失的鼻子、牙齒等細節,但當模型縮小後,3,000 個與 300 個三角形的差別就比較難辨認了
細節層級(Level of Detail)
我們可以為同一個物體準備不同細節層級(Level of Detail,LOD)的模型,再依照觀察距離或物體在畫面中的大小來選擇適合的版本。 這個想法與 Mipmap 類似:近處會需要細緻的表示,遠處則可以使用較粗略的表示
幾何模型在切換層級時,它的頂點數與連接關係也可能會改變,所以它的過渡會比影像層級之間的內插更麻煩。 如果我們直接切換模型,觀察者看見的輪廓可能會突然發生跳動
邊坍縮(Edge Collapse)
如果要刪掉一個三角形,我們不能直接刪除它,否則物體表面可能會留下洞。 這裡我們介紹一種稱為「邊坍縮(edge collapse)」的方法來刪三角形,它會把某條邊的兩個端點合併成一個頂點,再更新周圍的連接關係
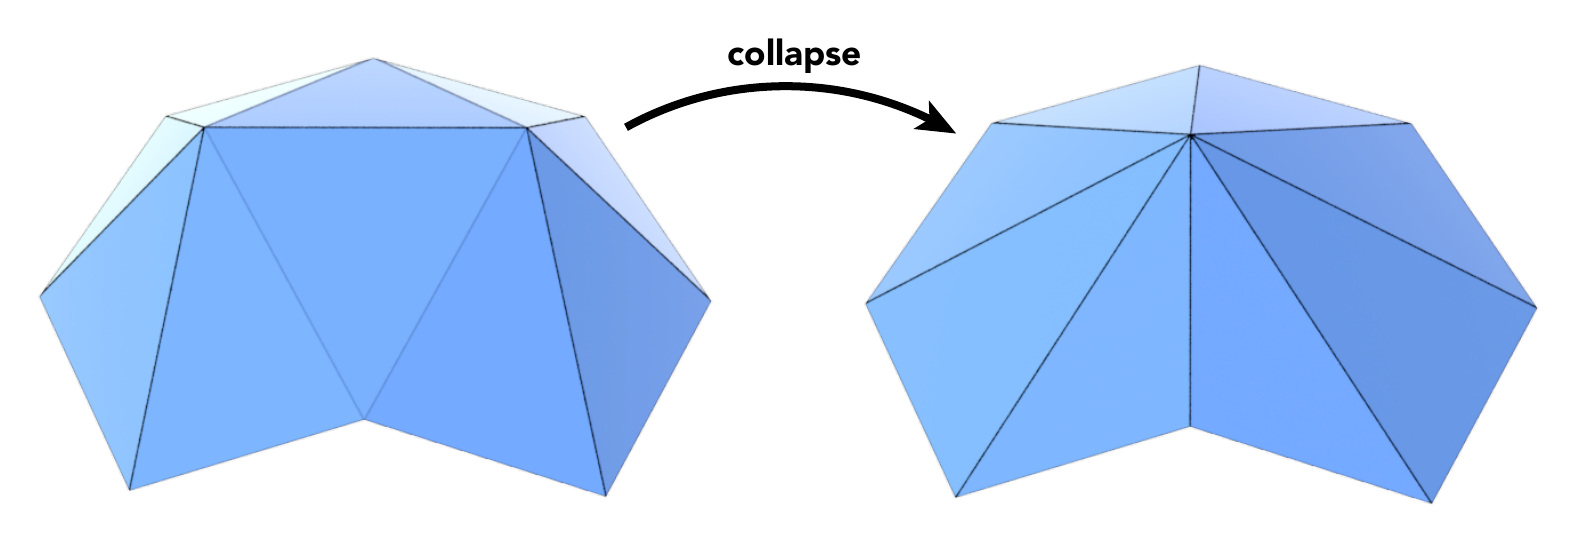
原本的邊會在合併後消失,部分與它相連的三角形也會因退化而被移除。 這個過程會有兩個問題:
- 新頂點應該放在哪裡
- 應該先坍縮哪一條邊
由於這兩個問題都需要一個能衡量形狀改變程度的誤差,所以我們現在來看一下二次誤差度量(Quadric Error Metrics)
二次誤差度量(Quadric Error Metrics)
二次誤差度量(Quadric Error Metrics,QEM)會用新頂點到相關平面的「距離平方和」來評估誤差。 這裡的二次指的是平方,演算法會尋找讓這個平方和最小的位置
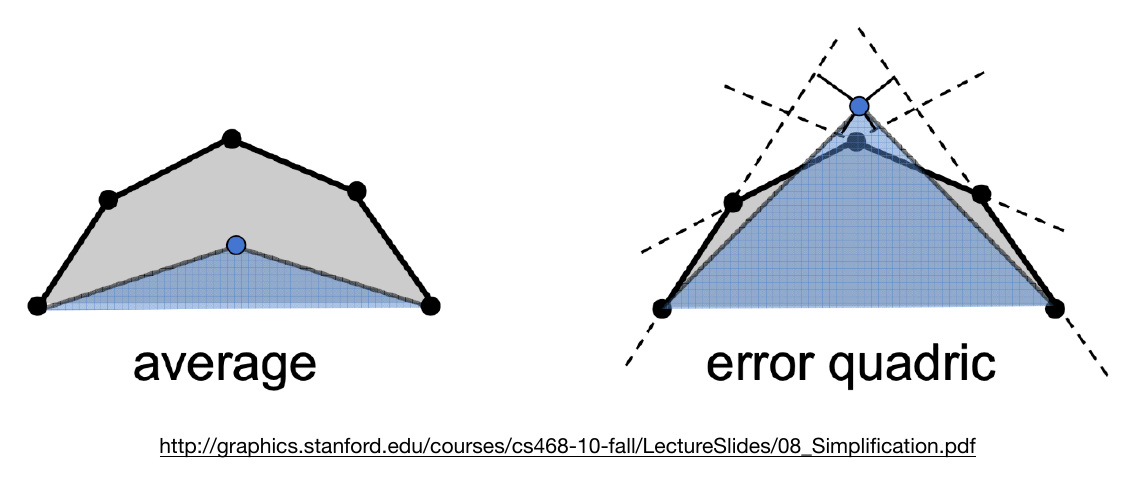
我們先看上圖的二維例子。 原本的折線包含了一段向上凸起的輪廓,如果我們把中間幾個頂點的位置直接平均掉,新頂點就會往內縮,簡化後的輪廓會變得太平坦
QEM 的做法是會去衡量新頂點到原本各條直線的距離。 如果是三維的情況,則會改成衡量新頂點到原本三角形所在平面的距離。 假設相關平面為
並將能讓誤差最小的新頂點寫作
也就是找到一個點,使它到所有
如果我們把第
這個向量可能斜斜地指向
又因為
代入後我們能得到:
兩邊平方後,就可以去掉絕對值了:
因此,誤差也可以直接寫成:
這個形式會把「距離平方和」變成可以計算的二次函數。 我們對
那麼這一項就是:
其中
對
最後,因為總和的導數等於各項導數的總和:
因此我們可以得到:
把括號展開,再把常數項移到右邊後可以得到:
它可以寫成熟悉的形式:
在三維空間中,這通常就是三條一次方程式,求三個座標
如果所有平面有唯一共同交點(此時係數矩陣可逆),答案就是那個交點; 如果沒有共同交點,答案就是使總誤差最小的折衷位置。 若平面方向不足以限制所有座標,最佳位置則可能不只一個,實作需要自己再另外選擇可用的位置
依照誤差選擇坍縮順序
我們可以為每條候選邊計算一個分數:演算法先假設這條邊會坍縮,再求出合併後的最佳位置與對應的最小誤差。 因為誤差較小的邊對原本形狀的影響比較小,所以會先被處理
由於每次坍縮都會改變附近的頂點與面,所以鄰近邊的候選位置及誤差也會跟著改變。 我們如果只在一開始排序一次,後面使用的分數就可能會過時。 因此演算法會在每次坍縮後,重新計算受影響區域的分數
我們可以用最小堆積來實作優先佇列,讓目前誤差最小的邊留在堆積頂端。 每一輪的流程如下:
- 取出目前誤差最小、且可以執行坍縮的候選邊
- 把兩個端點合併到該邊的候選位置,並更新附近的網格連接
- 移除失效的候選邊,再重算附近邊的誤差與候選位置
- 更新優先佇列,直到模型達到目標面數或允許的誤差
最小堆積能讓我們以
這個方法是一種貪心演算法,因為每一輪都只會選當下誤差最小的操作。 局部最佳的選擇不會保證最後的模型具有全域最小誤差,但課程展示的結果說明了這個方法在實際模型上可以保留許多重要特徵
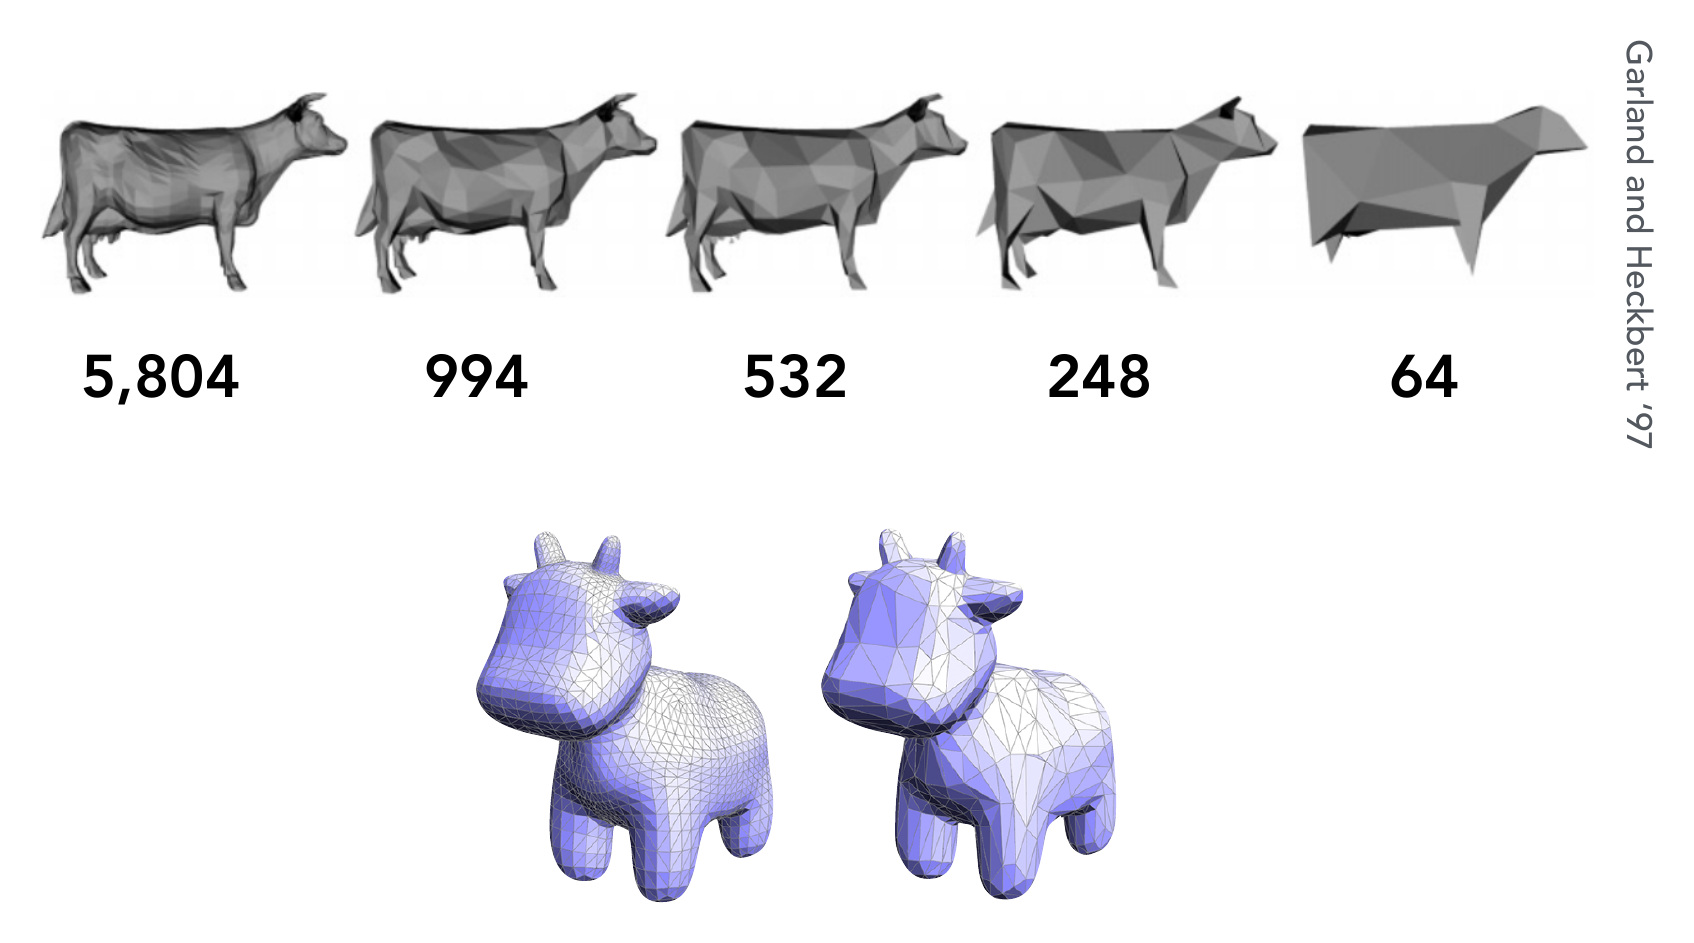
圖中的乳牛逐步從 5,804 個三角形減少到了 64 個三角形。 原本較平坦的區域會允許更多邊坍縮,所以簡化結果會在這些地方形成較大的三角形。 脖子、腿與其他形狀變化較大的地方則會傾向保留較密的網格,直到面數過少時,尾巴與細小結構才會開始消失